AI özelliği yayına çıktıktan sonra “iyi mi” sorusuna nasıl cevap verdiklerini, eval’ı kendi ürününde kurmuş ekipler anlatıyor.
Dört cevabın üçünde eval gerçek veriyle başlıyor: bir müşteri şikayeti, üretim transkriptleri ya da agent’ın yapması gereken gerçek bir görev. Hepsinde sonuç bir aksiyona bağlanıyor: doküman PR’ı, prompt değişikliği, model seçimi. Ayrıştıkları yer judge’a ne kadar güvendikleri; iki ekip kalibre etmeden güvenmiyor.

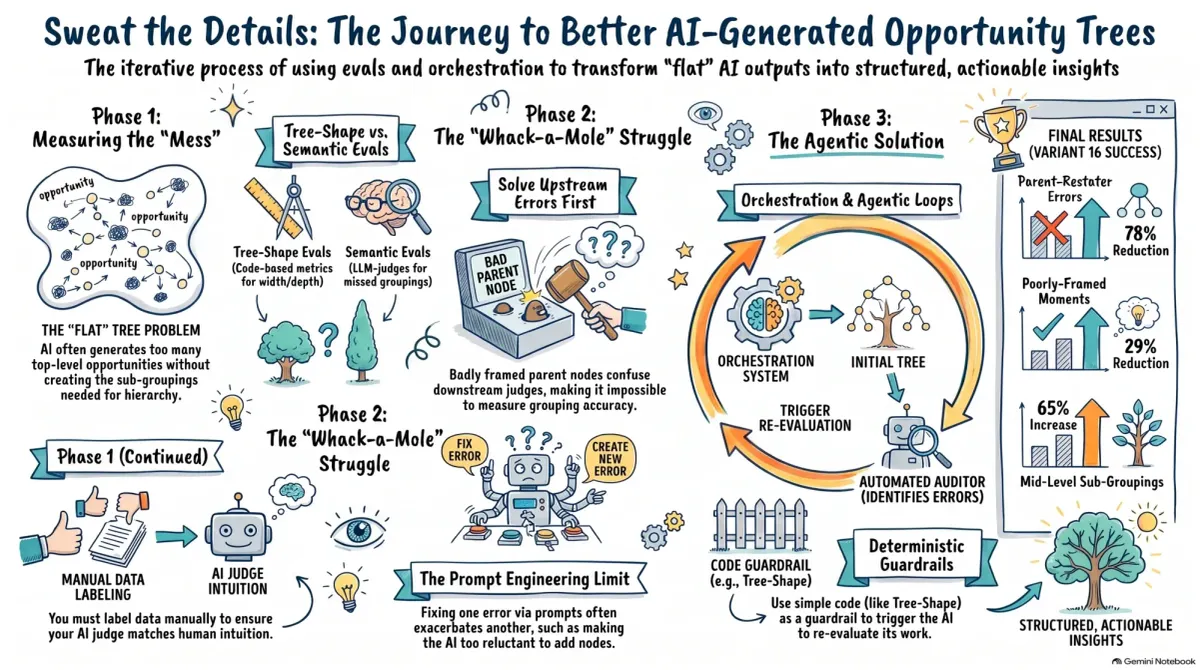
Bir beta müşterisi, AI’ın ürettiği opportunity solution tree’de bir dalın fazla düz kaldığından şikayet etti. Teresa Torres önce ağacın biçimini kodla ölçen bir eval, sonra kaçırılan gruplamaları LLM-as-judge ile değerlendiren ikinci bir eval yazdı. Judge laboratuvarda kusursuz çalıştı ama üretim verisinde yüzde 90’ın üzerinde hata verdi; nedeni üst adımlardaki hatalardı. Bunlar için iki eval daha kurdu ve prompt ile model değişikliklerini 16 deney varyantında denedi. Sonunda çözümü prompt’tan orkestrasyona taşıdı: ağaç biçimi eval’ını guardrail olarak kullanan bir denetle ve düzelt döngüsü kurdu. 16. varyant bir hata türünü yüzde 78, diğerini yüzde 29 azalttı.

Together AI’da agent’lar birçok ürünün çoğunluk kullanıcısı. Ürün ekibi, Claude Code’un yalnızca doküman ve bir API anahtarıyla gerçek görevleri tamamlayıp tamamlayamadığını ölçen agent eval’ları kurdu. Aynı görevi üç biçimde koşturuyor: yalnızca dokümanla, MCP sunucusuyla ve skill’lerle. Böylece hangi bağlam katmanının işe yaradığını görüyor. Sonuçlar bir iyileştirmeler sekmesinde somut düzeltmelere dönüşüyor; örneğin fine-tuning hızlı başlangıç sayfasındaki eksik bir linki düzelten doküman PR’ı. Ekip bu döngüden onlarca doküman düzeltmesi çıkardı.
Warp, Wilson adını verdiği yazılım fabrikasıyla ayda 2.000 PR gönderiyor. Sistem Slack, Linear ve GitHub’dan gelen istekleri alıyor, agent kodu yazıyor, testler otomatik koşuyor. Ekip her agent koşusunu LLM-as-judge ile puanlıyor. Maliyet ve kalite dengesini, aynı işleri farklı model konfigürasyonlarıyla yeniden koşturarak kuruyor ve PR başına maliyeti izliyor. Başarısız koşular sistemi iyileştirmek için geri besleniyor. PR başına insan müdahalesi sayısını otomasyon göstergesi olarak kullanıyor; darboğaz hala insan incelemesi.
Anthropic ekibi eval tasarımındaki iki riski tarif ediyor: belirsiz görevlerle ve yüksek varyansla kurulan eval ve fark edilmeden eval’a aşırı uyum. Eval’ı üretim transkriptlerinden, hata raporlarından ve elle yazılmış örneklerden kuruyor; en ucuz grader’ı seçiyor ve grader tutarlılığını kontrol ediyor. İyileştirme turlarında eval’ı rastgele train ve test olarak bölüyor, her turda tek değişiklik öneriyor ve train artıp test yerinde sayarsa değişikliği geri alıyor. Kendi claude-api skill’inde geçme oranını 66.1%’den 87.9%’a çıkardı. Müşteri destek benchmark’ında doğruluk 74.4%’ten 98.9%’a çıkarken bilet başına maliyet 4.6 sentten yaklaşık 1 sente indi; ayrı tutulan test setinde sonuç 90.5% oldu.
AI özelliği olan her ekip aynı yere geliyor: demo çalışıyor, ama yayındaki çıktının iyi olup olmadığını kimse söyleyemiyor. Eval bu sorunun cevabı olarak anlatılıyor, fakat anlatıların çoğu genel rehber. Biz kendi ürününde kurmuş ekiplerin ne yaptığını görmek istedik.
Cevaplarda ortak nokta, eval’ın bir ölçüm projesi olarak değil bir düzeltme aracı olarak kurulması. Hangi veriden başladıkları, judge’a ne zaman güvendikleri ve sonucu neye bağladıkları ekipten ekibe değişiyor; soru bu farkları yan yana koyuyor.
Tasarım, ürün ve yapay zekadan seçtiğimiz en iyi okumalar, iki haftada bir çarşamba posta kutunda.