Bir AI ürünü için yazdığın cevap doğru mu, yanlış mı? Yandex'te Türkiye aramasının ve AI asistanı Yazeka'nın ürün tarafını yöneten Rufat Mirza'ya göre bu soru baştan yanlış. AI'da doğru ya da yanlış yok; daha iyi ya da daha kötü var. Ölçmenin işi de tam burada başlıyor.
Rufat konuşmaya ürün yönetiminin eski bir kuralıyla girdi: ölçmediğin şeye sahip değilsin. AI ürünlerinde bu kural daha da sert işliyor, çünkü klasik yazılımdan bir noktada ayrılıyorlar. Deterministik değiller. Aynı soruya her seferinde aynı cevabı vermiyorlar. Rufat'ın ifadesiyle, bu yüzden bir AI ürününe olduğu haliyle güvenemezsin. Güveni sistematik bir yöntemle kurman gerekiyor.
ProblemTek bir tarif sorgusu
Konuşmanın tamamı tek bir sorgunun etrafında döndü. Rufat salona Azerbaycan pazarı için bir yemek uygulaması geliştirdiğimizi hayal ettirdi ve şu sorguyu gösterdi: “Elimde tavuk filetosu, patates, soğan, domates ve zeytinyağı var. İki kişilik, en fazla 30 dakikada hazırlanan bir yemek tarifi yaz.”
İlk cevap iki kısa paragraftı. Malzemeler ve pişirme adımları aynı metnin içinde. Rufat salona sordu: bu cevap yanlış mı? Birkaç el kalktı. Doğru mu? Yine birkaç el. Asıl soruyu sonra sordu: bu cevap daha iyi olabilir mi? Bu sefer salonun çoğu el kaldırdı.
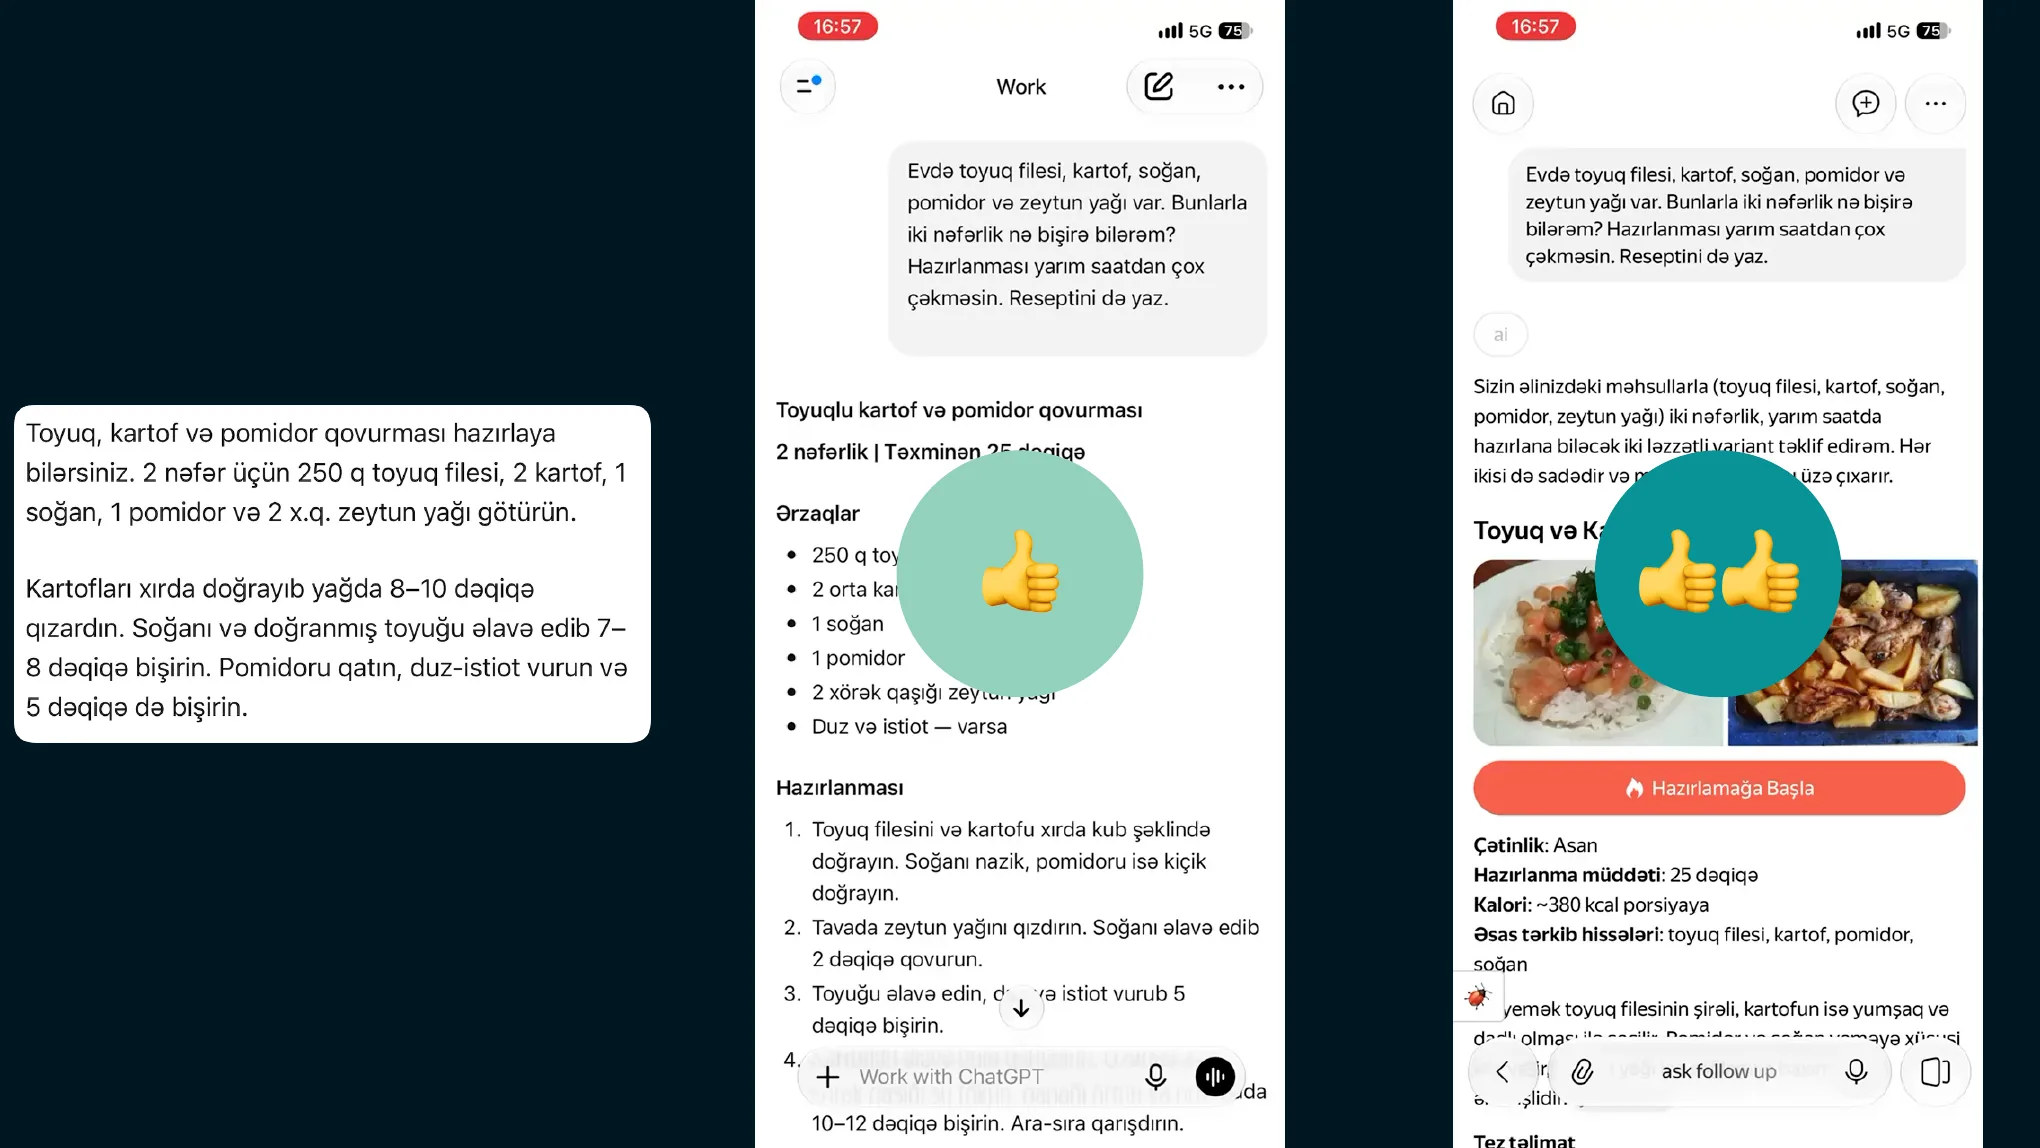
Ortadaki ChatGPT cevabı malzemeleri ve hazırlanışı ayrı bölümlerde veriyor; Rufat buna bir başparmak verdi. Sağdaki ise Yandex Türkiye ekibinin geçen yıl kurduğu cevap: birden fazla tarif seçeneği, malzemelerin tek tek görselleri, hazırlanışı anlatan videolar, kalori ve süre bilgisi. Üstüne tarifin malzemelerini tek tıkla bir market teslimat uygulamasından sipariş etme imkanı. Rufat bunun bir övünme olmadığını, sadece çift başparmağı neyin hak ettiğini göstermek istediğini söyledi.
Bu ürün daha iyi olabilir mi? Bu soruyu sormak senin işin. Bugün en iyi kabul edilen cevabı alıp yarın daha iyisine itmek.
Rufat Mirza, Yandex · Senior Product ManagerRufat'a göre insan muhakemesinin ve zevkin hala değerli olduğu yer burası: her şey bu kadar hızlı değişirken, iyi kabul edilen bir şeyi alıp ileri taşımak.
SpektrumDoğru ya da yanlış değil, beş basamak
Kötü tarafın da dereceleri var. Rufat aynı tarifi bu kez İngilizce gösterdi. İçerik neredeyse ChatGPT cevabı kadar düzgündü ama Azerbaycan'da mutfağında yemek yapan bir kullanıcı için yanlış dildeydi. Bunun bir altı da var: İngilizce cevabın içine Çince karakterler karışmış bir versiyon. Bu sadece dil hatası değil, itibar hatası. Kullanıcıya eski ve ucuz bir model kullandığını söylüyor. Bir girişim için tolere edilebilir, büyük bir şirket için edilemez.
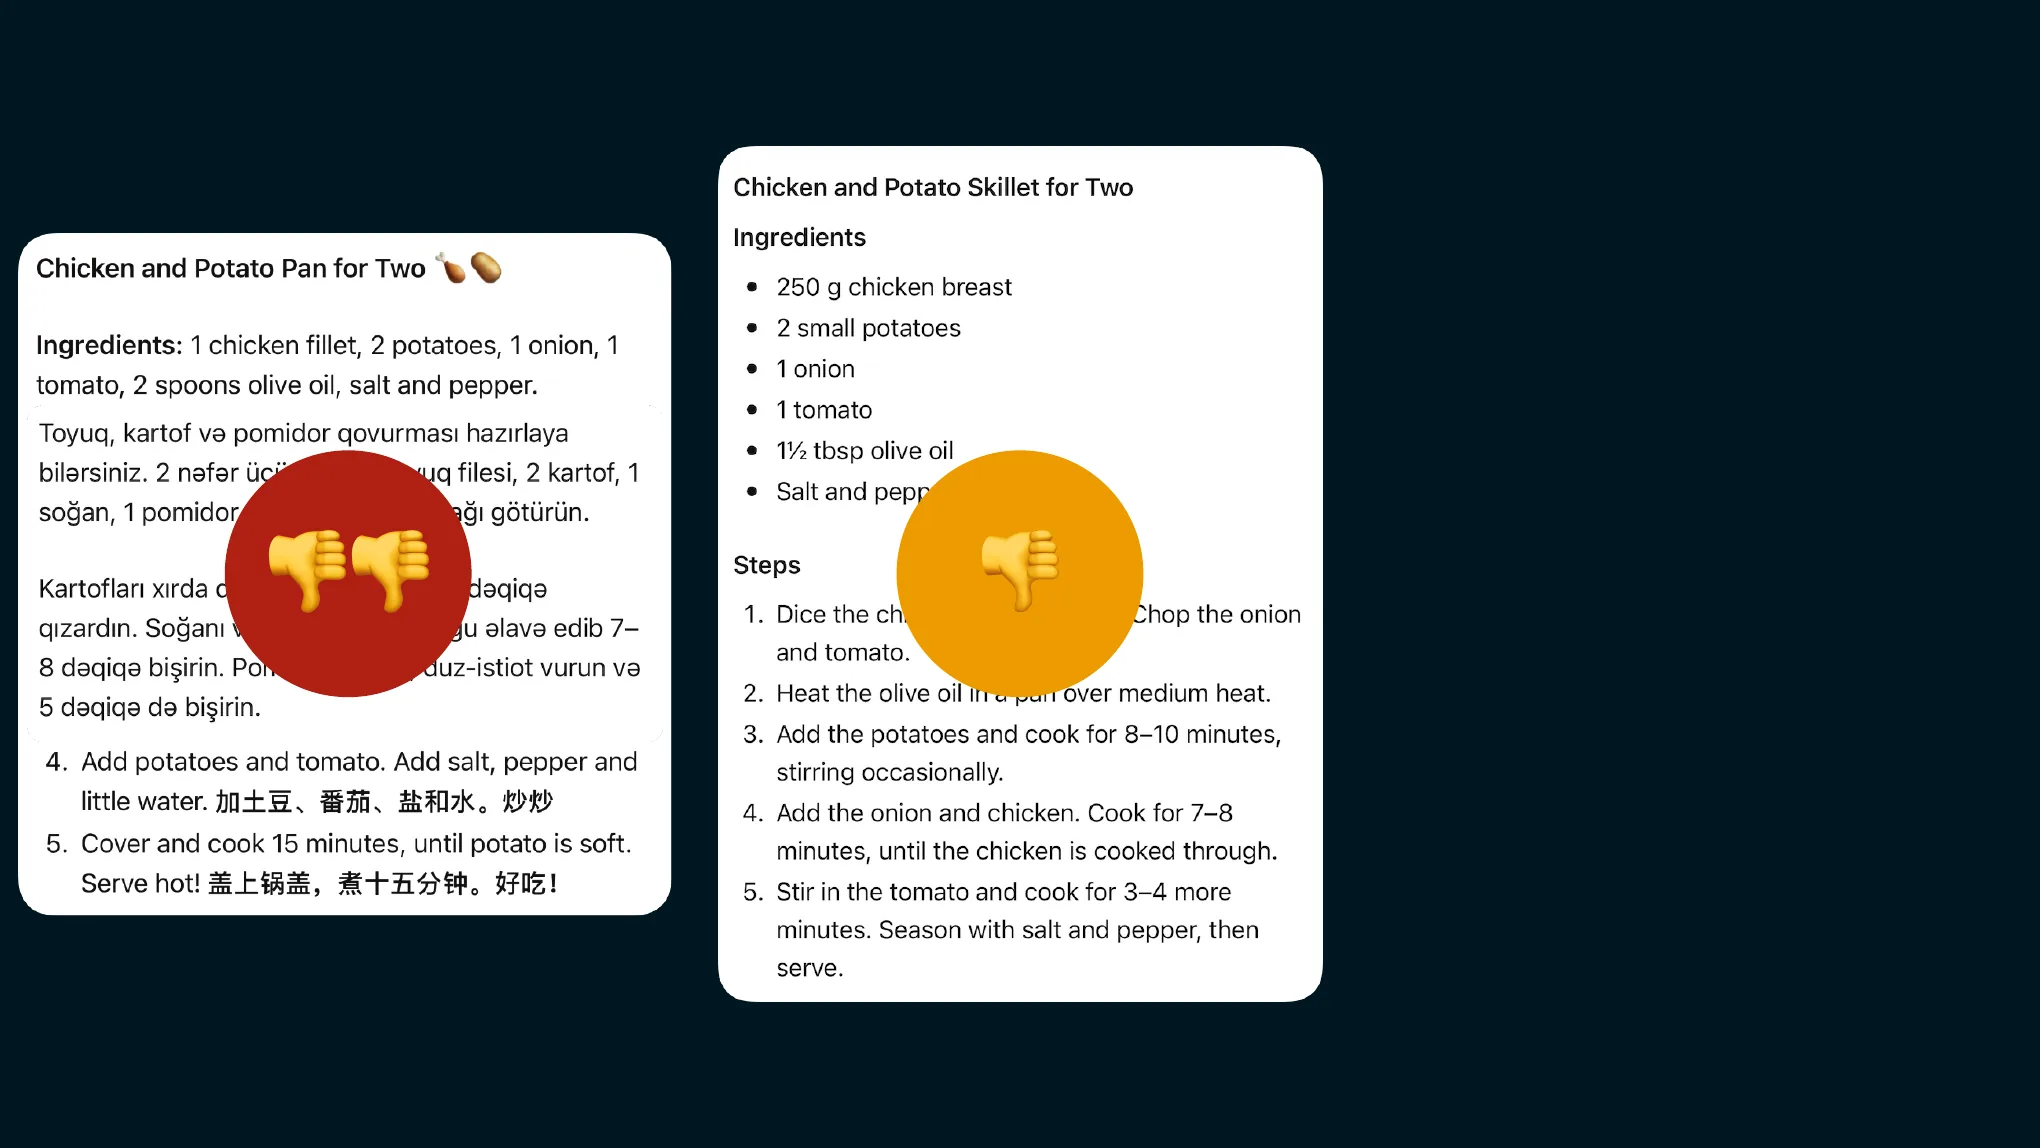
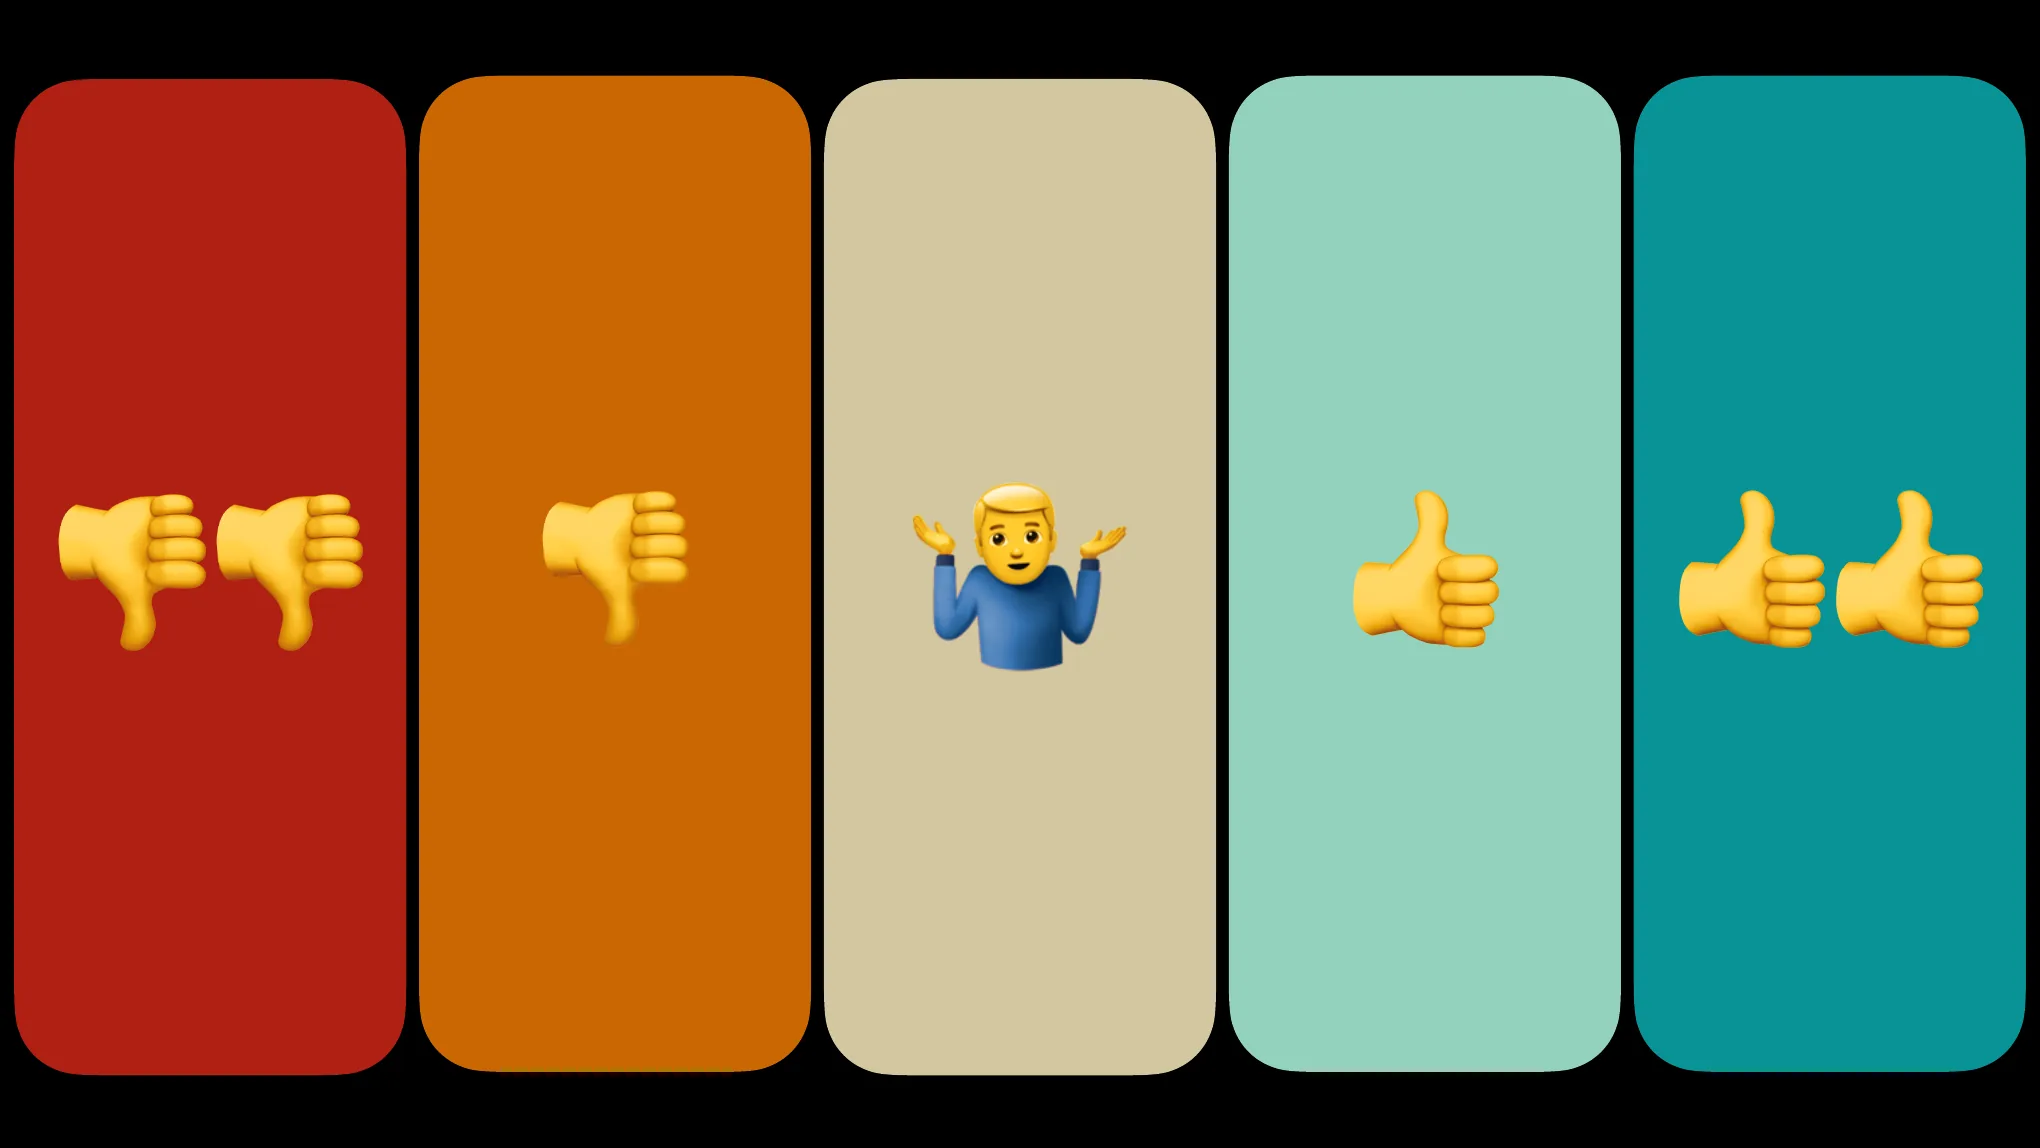
Böylece elinde beş basamaklı bir ölçek oluyor: çift aşağı başparmaktan çift yukarı başparmağa. Tek bir örnekten sonra bile yeni gelen her cevabı bu ölçeğin bir yerine koyabiliyorsun.
Yönerge, sepet ve hakem
Tek bir sorgudan iki şey çıkıyor. Birincisi bir kural listesi. Rufat sadece bu tarif örneğine bakarak on kadar kural sıraladı:
| İyi bir tarif cevabı için yönergeden örnekler |
|---|
| Cevap kullanıcının dilinde olmalı, yabancı karakter içermemeli. |
| Belirsiz sorgularda birden fazla tarif sunmak daha iyi. |
| Tarif yerel malzemelerle yapılabilmeli. |
| Güçlü alerjenler belirtilmeli, kalori bilgisi verilmeli. |
| Malzemeler ve adım adım hazırlanış ayrı gösterilmeli. |
| Malzemelerin küçük ikon ya da görselleri olmalı; cevap tarifi anlatan bir görselle açılmalı. |
| Videoyla desteklenen tarifler daha kullanışlı. |
Bunları tek bir belgede topladığında bir yönergen (guideline) oluyor. İkincisi tek sorgunun yetmemesi. On, yüz, bin sorguda ne olacağını görmek için bir veri setine ihtiyacın var. Yandex bunun adına sepet (basket) diyor.
Sepeti kurmanın iki ucu var. Bir ucu yarım saatlik iş: ekip arkadaşlarınla oturup gerçek hayatta karşılaşacağını düşündüğün 50-100 kullanıcı senaryosunu yazıyorsun, sonra bir AI'a verip çoğaltmasını istiyorsun. Öbür ucu altı ay gece gündüz çalışan bir ekip. Çünkü kullanıcılar senin hayal ettiğin düzgün sorguları getirmiyor: uygunsuz içerik, sohbet, etik açıdan sorunlu talepler, hepsi geliyor. Yandex'te bunlar için ayrı bir ekip çalışıyor. Başlangıç için gereken şey kullanıcı davranışını temsil eden bir sepet.
Sonra hakem devreye giriyor. Sepetten bir sorgu alıyorsun, kendi modeline veriyorsun, cevabı alıyorsun. Sorguyu, cevabı ve yönergeyi güçlü bir LLM'e verip “bu yönergeye göre cevabı değerlendir” diyorsun. LLM bir karar (verdict) döndürüyor. Bunu sepetteki her sorgu için tekrarlıyorsun.
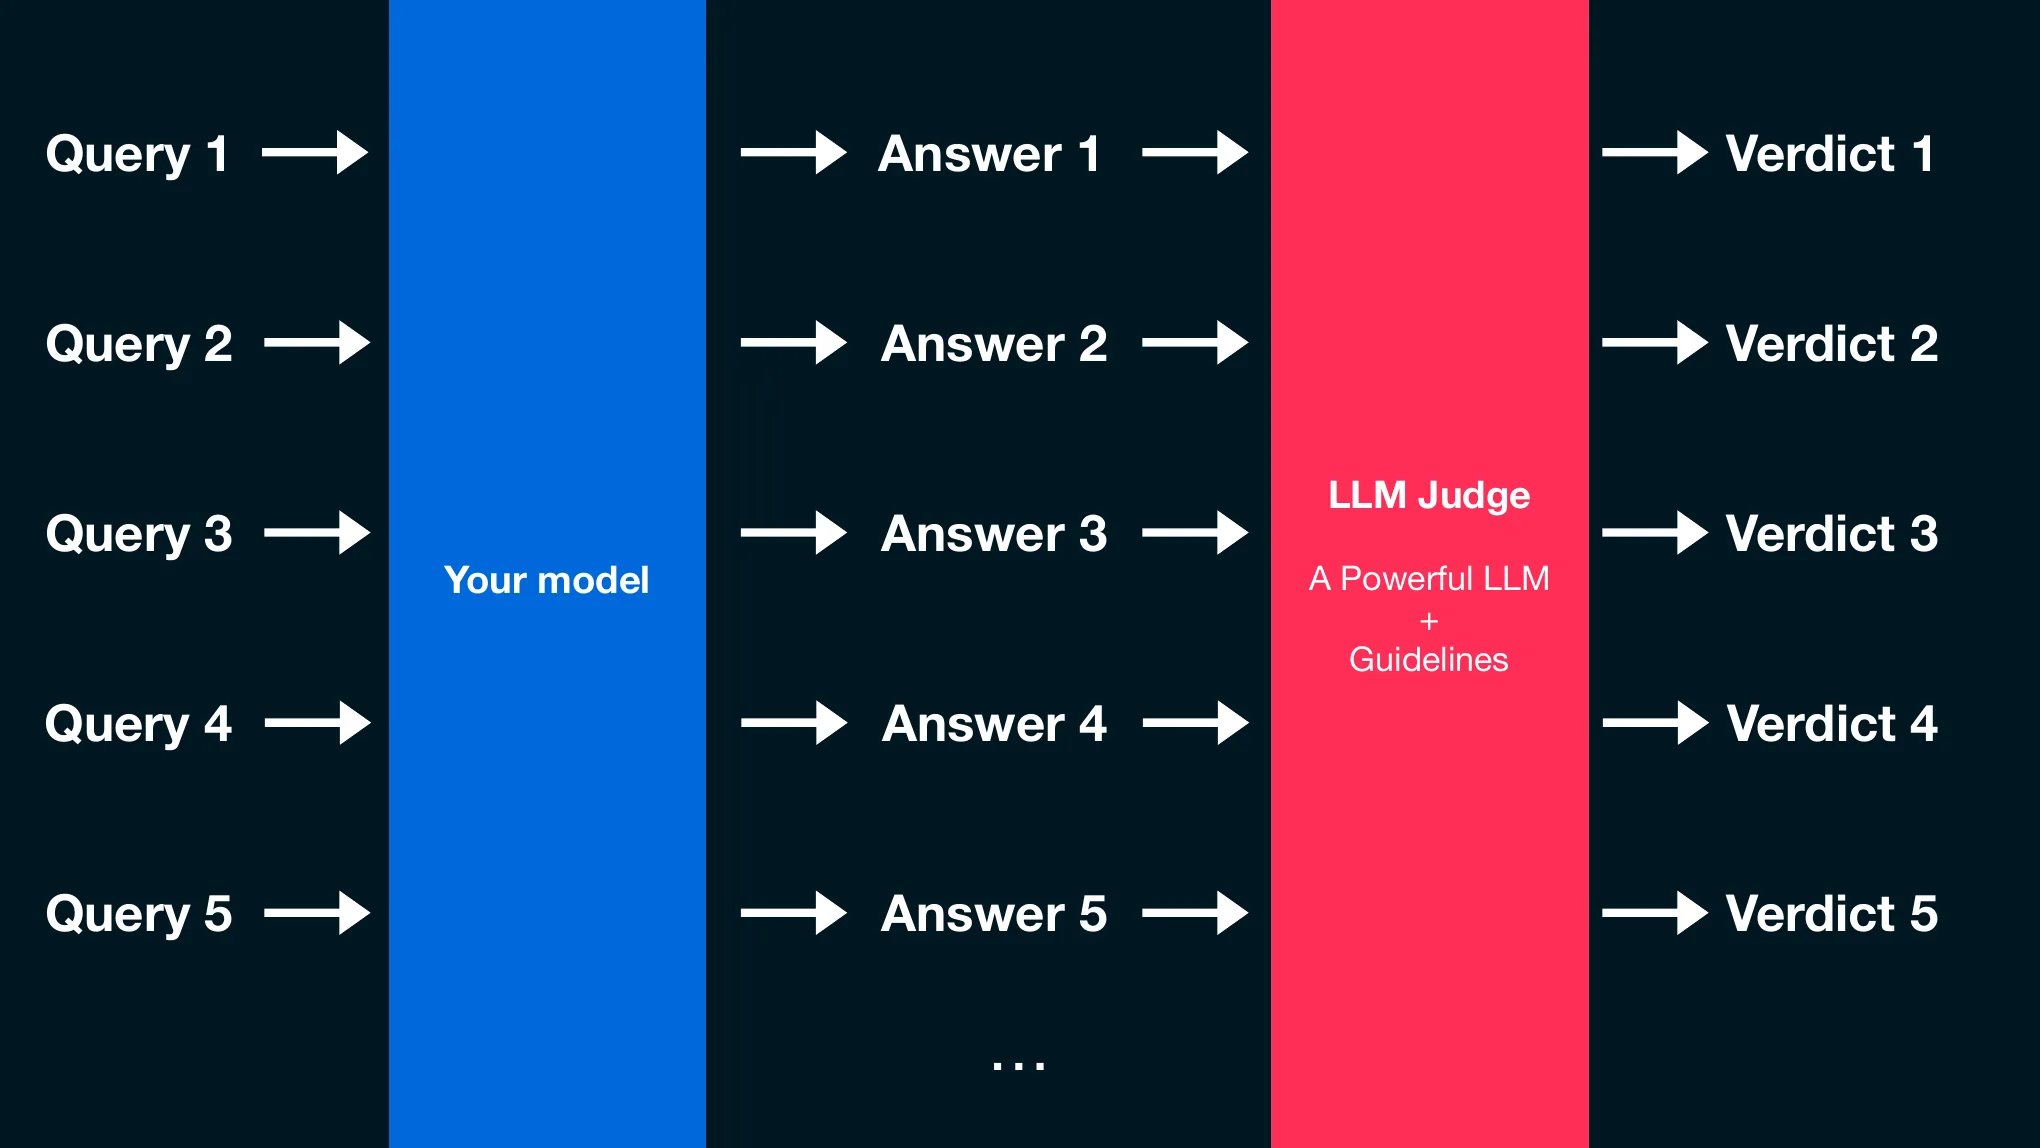
Kararlar sadece geçti/kaldı değil, neden kaldığını da söylüyor: tarif uydurma bir malzeme içeriyor (doğruluk), bulunması zor malzemeler var (yerellik), adım adım hazırlanış yok (kullanışlılık). Örnekte beş karar var ama Rufat'a göre yüze çıktığında sonuç istatistiksel olarak anlamlı olmaya başlıyor. O noktada “sistemim zamanın yüzde 60'ında iyi çalışıyor, kalan yüzde 40'ta şu şu şekillerde sorunlu” diyebiliyorsun.
Yönerge büyüyünce hakemlere bölünür
Yüz sorguyu değerlendirdiğinde o kadar çok kural birikiyor ki tek belge taşımıyor. Belgeyi parçalara ayırıyorsun: etik, dil yetkinliği, kullanışlılık, doğruluk ve diğerleri. AI dünyasında bunlara yönerge değil hakem (judge) deniyor. Her hakem aslında bir prompt.

Bu sürecin en işe yarar çıktısı bir yapılacaklar listesi. Ekip hangi sorunun ne sıklıkla çıktığını görüyor ve önceliklendiriyor. Tariflerde ilgisiz yemek görselleri çıkıyorsa yüksek öncelik. Malzeme ve hazırlanışta çelişen bilgi varsa yüksek öncelik. Anahtar bilgilerin kalın yazılması gibi iyileştirmeler düşük öncelik.
RakipKör karşılaştırma ve tek metriğin yanıltması
Rufat'ın ikinci önemli pratiği rakip karşılaştırması (side-by-side). Sadece kendi yönergene göre değerlendirmek yetmiyor; rakip ne yaparsa yapsın, her zaman sende olmayan bir şeyi vardır. Yandex'in Google'dan ve ChatGPT'den çok şey öğrendiğini açıkça söyledi.
Yöntem şöyle: aynı sorgular beş farklı modele veriliyor, biri rakip. Ekipten biri model etiketlerini gizliyor, böylece kimse kendi ürününe taraf tutamıyor. Herkes cevapları aynı -2 ile +2 ölçeğiyle puanlıyor. Sunumdaki tablo, Yandex'in gerçek çalışma tablosunun anonimleştirilmiş hali.

Değerlendirmenin sonunda elinde birkaç sayı oluyor. Sunumdaki örnek tablo neden tek bir metriğe bakmaman gerektiğini iyi gösteriyor:
| Metrik | Prototip | Rakip |
|---|---|---|
| Olumlu ya da çok olumlu cevap oranı | %70 | %64 |
| Kritik hata oranı (çift aşağı başparmak) | %5 | %2 |
| Etik sorunlu cevap oranı | %1'in altında | %1'in altında |
| Kullanışlılık sorunu oranı | %10 | %14 |
| Ortalama ilk token süresi (TTFT) | 9 sn | 6 sn |
| Kazanma / kaybetme oranı | %45 | %55 |
Prototip olumlu cevap oranında önde ama kritik hatada geride, daha yavaş ve doğrudan karşılaştırmada kaybediyor. Sadece olumlu cevap oranına bakan bir ekip yanlış bir zafer ilan ederdi. Kritik hataların çift aşağı başparmak olduğunu hatırla: tek bir Çince karakterli tarif, on iyi tariften daha çok konuşulur.
Tablodaki sayılar bir örnek
Tablo sunumdaki örnek bir değerlendirmeden; Yandex'in yayımladığı bir ürün karşılaştırması değil ve rakibin adı verilmiyor. Sayıların değeri mutlak düzeyde değil, metrikler arasındaki gerilimi göstermesinde. Kendi sepetin ve kendi hakemlerinle çok farklı sonuçlar alman doğal.
Rufat bir noktanın altını özellikle çizdi: “rakip” yazan sütun senin geçen yılki modelin de olabilir. Önemli olan ölçümün aynı sepetle ve aynı (gelişen) kurallarla tekrar tekrar yapılması. Bir kez ölçtüğünde elinde bir nokta var. On kez ölçtüğünde bir grafik var. Grafik olunca raporlayabiliyor, KPI'ına ulaşıp ulaşmadığını gösterebiliyorsun.
DöngüHatalı sorgu sepete geri döner
Konuşmanın son slaytı bütün fikri tek bir döngüde topladı. Bu bir kez yapılan bir iş değil, sürekli dönen bir süreç.

Bir sorgu ve on kuralla başlıyorsun. Hakemlere ve rakip karşılaştırmasına veriyorsun. Analiz edip düzeltiyorsun. Test kullanıcılarına ya da canlıya çıkıyorsun. Gelen hataları, kullanıcının beğenmeme butonuna bastığı sorgular dahil, aynen alıp sepete geri koyuyorsun. Döngü her döndüğünde sepet gerçek kullanıma biraz daha benziyor ve ürün ölçülebilir şekilde iyileşiyor.
Eval bir test aşaması değil, ürünün kendisini geliştirme biçimi.
Soru-cevapSon üç ay, önceki iki yıldan fazla
Soru-cevap Türkçe ve Azerbaycanca karışık geçti. İlk soru kişiseldi: Rufat AI'ı kendi işinde ne zaman kullanmaya başladı? Cevabı, geçen yıl sorulsa “bir yıldır” diyeceği yönündeydi. Ama son üç ayda yeni modellerin art arda çıkmasıyla, önceki iki yılın toplamının kat kat fazlasını kullanmış.
Salondan gelen ek soru, her hafta yeni bir model çıkarken bunun stres yaratıp yaratmadığıydı. Rufat'ın cevabı dürüsttü: evet, iş yükü açısından stres var, çünkü her yeni model onun ekibi için yeni bir değerlendirme işi demek. Ama işini elinden alacağı korkusunu taşımıyor. Eskiden yazılım geliştiren biri olarak, yaratıcı bir şey üretmek için daha önce hiç sahip olmadığı araçlara şimdi sahip olduğunu söyledi.
İkinci soru yöntemin kendisine yönelikti: bugüne kadar insan değerlendiricilerin Excel'e işlediği puanlamayı LLM'e devretmek sadece bir hızlanma mı, yoksa yeni bir şey mi? Rufat ikisinin de olduğunu söyledi. Bu işleri iki yıl kadar önce LLM'lere vermeye başladıklarında amaç hızdı. Ama bir noktada hızlanmanın ötesine geçti: araçlar daha önce mümkün olmayan derinlikte analiz yapmayı mümkün kıldı. Artık sadece zaman değil, içgörü kazandırıyor.
Yarın başlamak için yarım saat yeter
Ekibinle otur, ürününe gelen 50 gerçekçi sorguyu yaz ve bir AI'a çoğalttır. Tek bir sorguya verdiğin cevabı alıp “bu daha iyi olabilir mi” diye sor; cevaplarından ilk on kuralını çıkar. Sonra aynı sepeti bir LLM hakeme ver. İlk ölçümün kusurlu olacak; önemli olan aynı sepetle ikinci kez ölçebilmen.
Senin ürününde “daha iyi” cevabı bugün kim tarif ediyor: bir yönerge mi, yoksa toplantıdaki en yüksek ses mi? 🧱
Alive Baku etkinlik sayfası, konferansın diğer konuşmaları ve programı burada.