MIT'in beş aylık komitesi kopyayı nasıl yakalayacağını değil, yakalamaktan neden vazgeçtiğini yazdı.
13 Ağustos 2026'da MIT, Ad Hoc Committee on AI Use in Teaching, Learning and Research Training raporunu yayımladı. Komite Ocak 2026'da Chancellor Melissa Nobles, Provost Anantha Chandrakasan ve Faculty Chair Roger Levy'nin görevlendirmesiyle kuruldu. İçinde her okuldan öğretim üyesi, lisans ve lisansüstü öğrenciler, MIT Libraries ve Teaching and Learning Lab personeli var. Beş ay çalıştı, ekleriyle birlikte yayımladı.
Rapor eylülün ikinci haftasında X'te dolaşıma girdi ve iki günde milyonlarca kişiye ulaştı. Ama dolaşan şey raporun kendisi değil, bir özeti. Aradaki fark bu yazının konusu.
Raporun söylediği: gözetim değil, format
Komitenin teşhisi sert. Ödevler ve eve verilen sınavlar artık bir şey kanıtlamıyor, çünkü lisans müfredatındaki neredeyse her yazılı görevi bir dil modeli inandırıcı biçimde üretebiliyor. Rapor öğrencilerin ilk zorlanma anında modele uzanmasına bir ad da veriyor: cognitive surrender.
Beklenen cevap gözetimi sıkmaktı. Komite tam tersini yaptı. AI dedektörlerine güvenilmemesini öneriyor; gerekçesi hem bir silahlanma yarışı başlatması hem de ana dili İngilizce olmayan öğrencileri haksız yere işaretlemesi. Kilitli tarayıcılar için de aynı çizgide duruyor.
Bu araçlar hatalı ve arıza çıkarıyor, üstelik gözetim altındaymış hissi veriyor.
MIT Ad Hoc Committee raporu, 13 Ağustos 2026 ("buggy, error-prone and feels like surveillance")Yerine önerdiği şey teknik değil, editoryal: sözlü sınav, dönem boyunca biriken portfolyo, sınıf içi konuşma, deneyimsel ve proje tabanlı öğrenme. Notlandırma da masada. Rapor doğrudan "GPA'i kaldırın" demiyor; notun ne işe yaradığının yeniden düşünülmesini ve yeterlilik temelli değerlendirmenin araştırılmasını öneriyor. Bir de araştırma tarafına uyarı var: lisans öğrencisi araştırma asistanlarını ucuz diye AI ajanlarıyla değiştirmeyin, çünkü üniversite çıktı üretmek için değil insan yetiştirmek için var.
Manşetteki yüzde 46 tek bir sayı değil
Viral özetin taşıdığı rakam şu: MIT lisans öğrencilerinin yüzde 46'sı her gün dil modeli kullanıyor. Doğru bir cümle. Ama raporun eklerine bakınca yüzde 46 üç ayrı yerde çıkıyor ve üçü birbirinden farklı soruya ait.
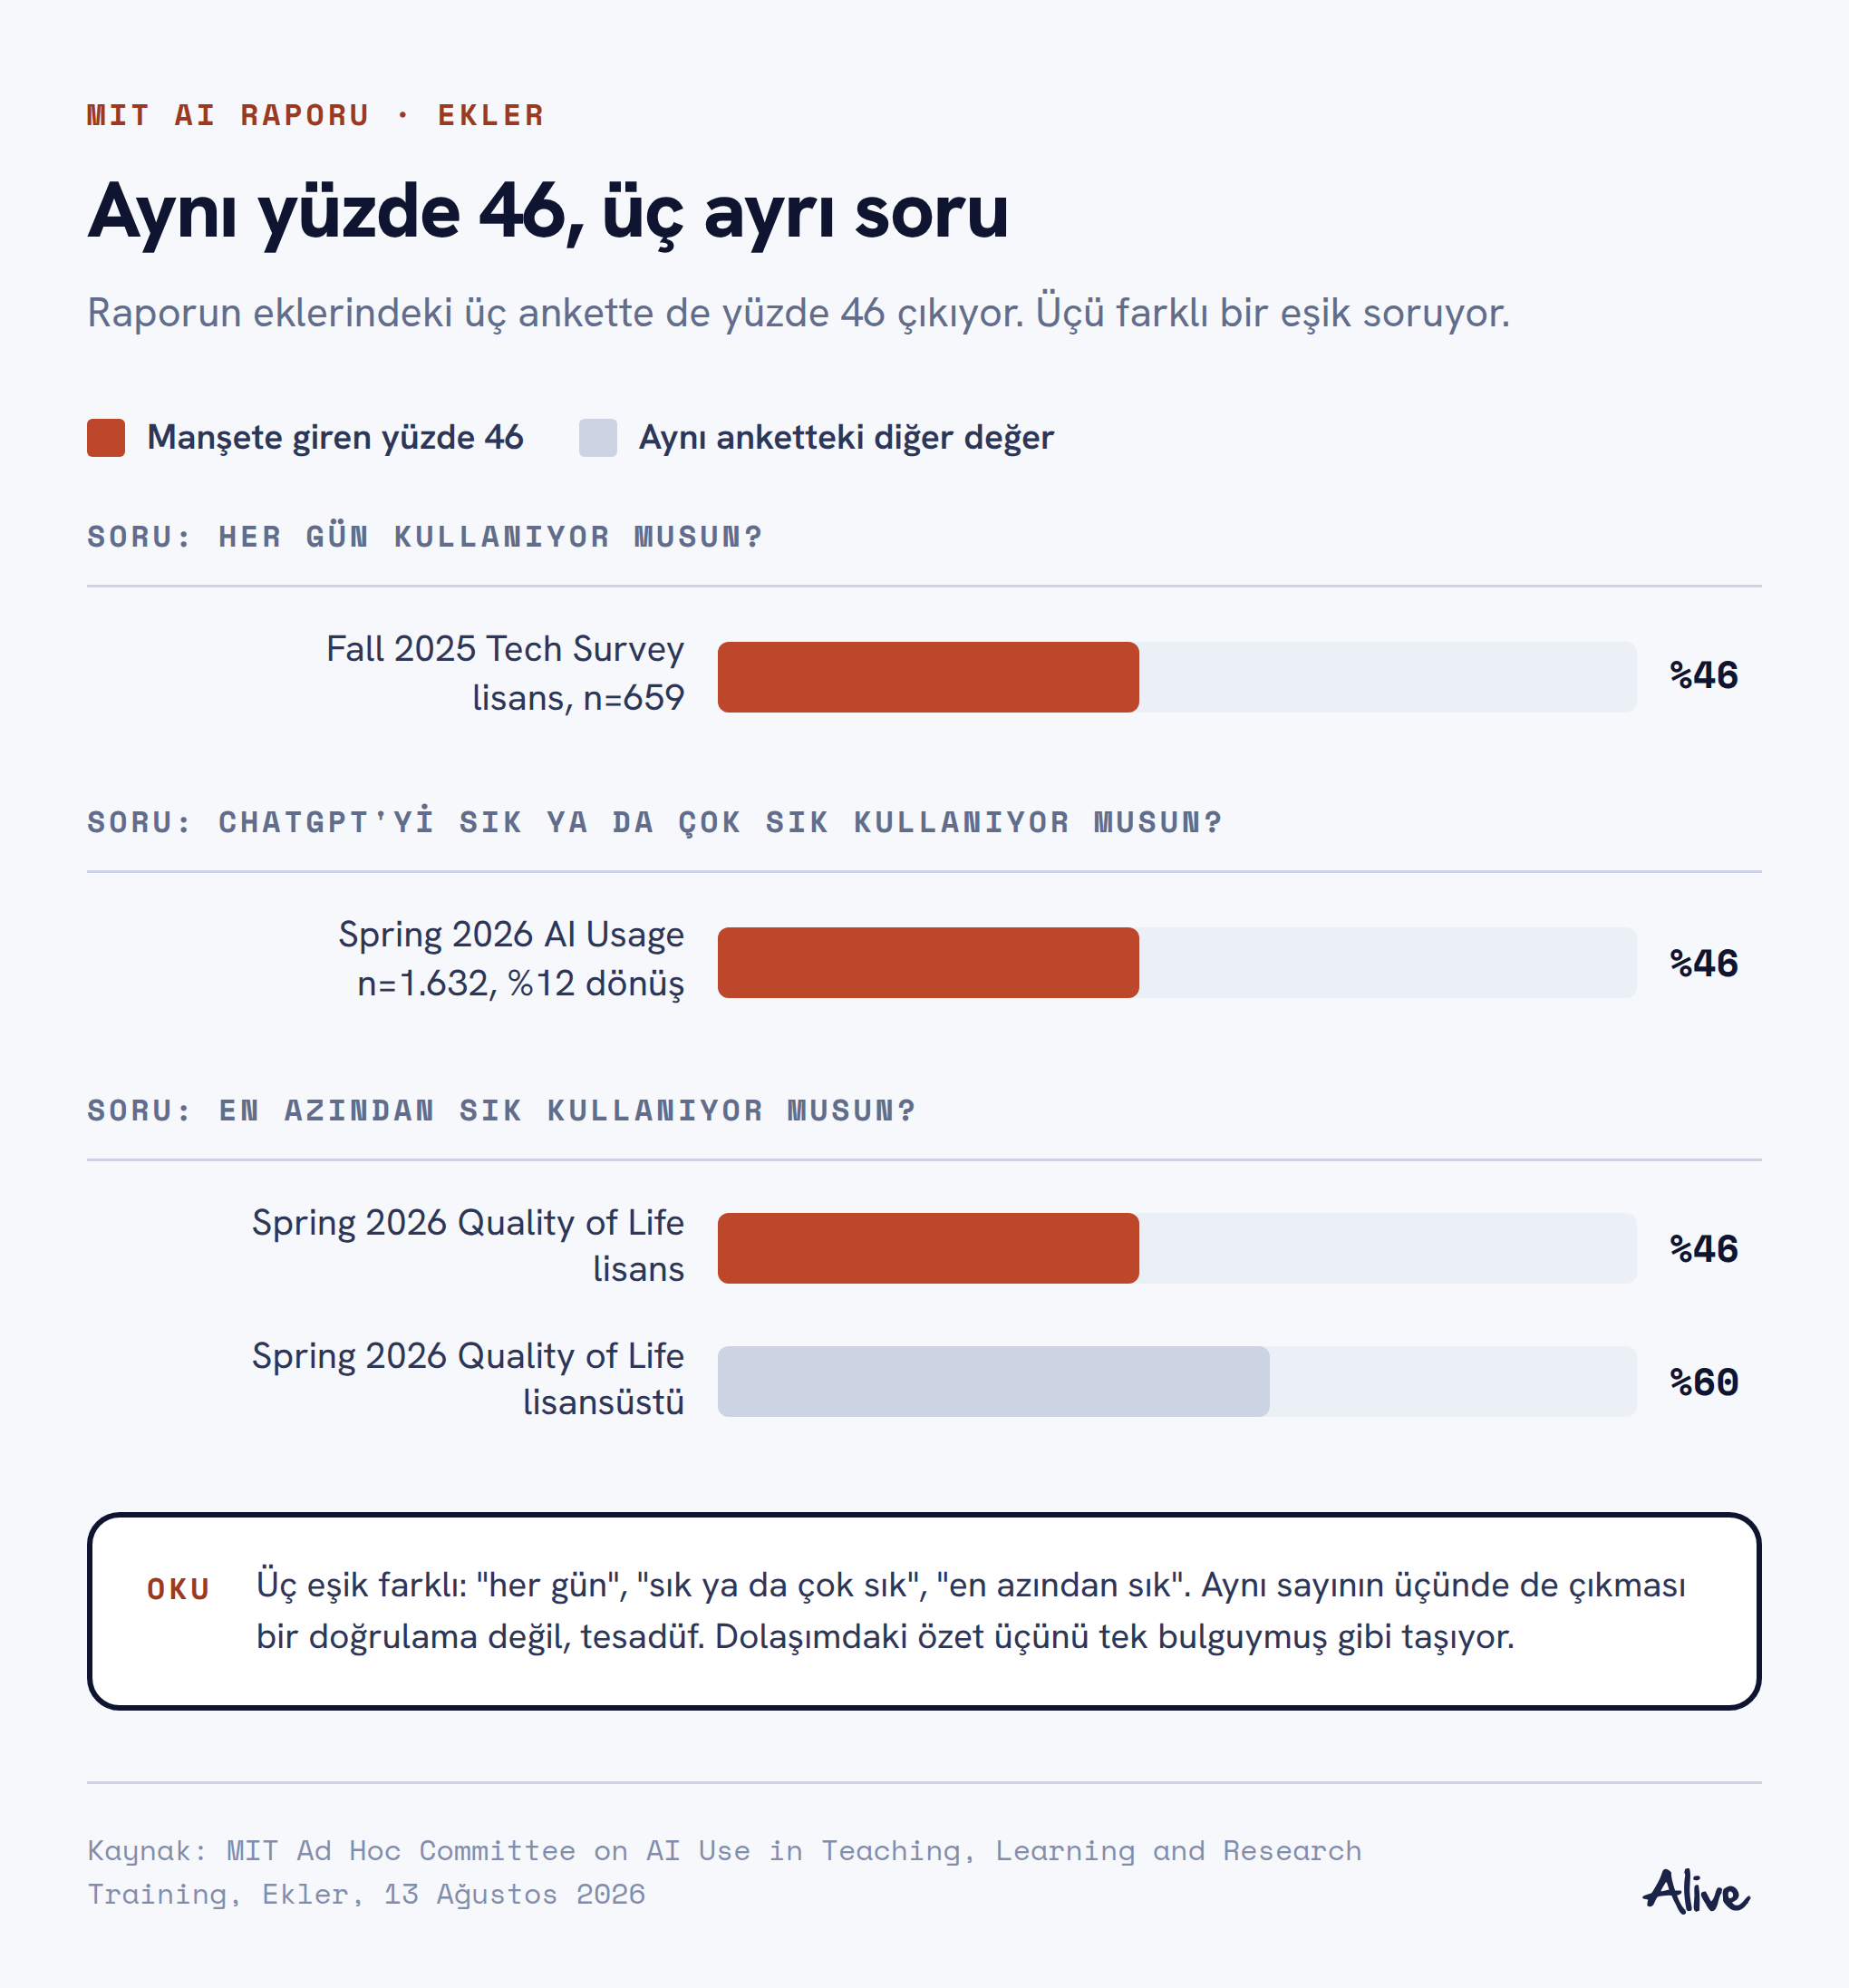
Fall 2025'te öğrenci gazetesi The Tech "her gün kullanıyor musun" diye sordu, yüzde 46 aldı. Spring 2026 AI Usage and Attitudes anketi "ChatGPT'yi sık ya da çok sık kullanıyor musun" diye sordu, yüzde 46 aldı. Spring 2026 Quality of Life anketi "en azından sık" eşiğiyle sordu, lisansta yüzde 46, lisansüstünde yüzde 60 aldı. Üç farklı eşik, üç farklı örneklem, aynı sayı. Bu bir doğrulama değil, tesadüf. Dolaşımdaki özet ise üçünü tek bir bulguymuş gibi taşıyor.
| Anket | Kim, ne zaman | Örneklem | Sorduğu şey |
|---|---|---|---|
| Fall 2025 Tech Survey | Öğrenci gazetesi The Tech, 4-18 Kasım 2025 | 1.002 kişi (659 lisans, 248 lisansüstü ve doktora sonrası, 18 öğretim üyesi, 72 personel), gönüllü katılım | Günlük kullanım sıklığı ve aşırı bağımlılık kaygısı |
| Spring 2026 AI Usage and Attitudes | MIT, bahar 2026 | 1.632 yanıt, yüzde 12 dönüş oranı | "Sık / çok sık" ChatGPT kullanımı |
| Spring 2026 Quality of Life | MIT kampüs geneli, bahar 2026 | Yaklaşık 8.200 yanıt | "En azından sık" kullanım eşiği |
Aynı eklerde daha az dolaşan ama daha çok şey söyleyen bir çift sayı var. Lisans öğrencilerinin yaklaşık yüzde 70'i AI yetkinliğinin kariyeri için kritik olduğunu söylüyor. Aynı gruptan yalnızca yüzde 25'i MIT'in kendisini bu araçları profesyonelce kullanmaya hazırladığını düşünüyor.
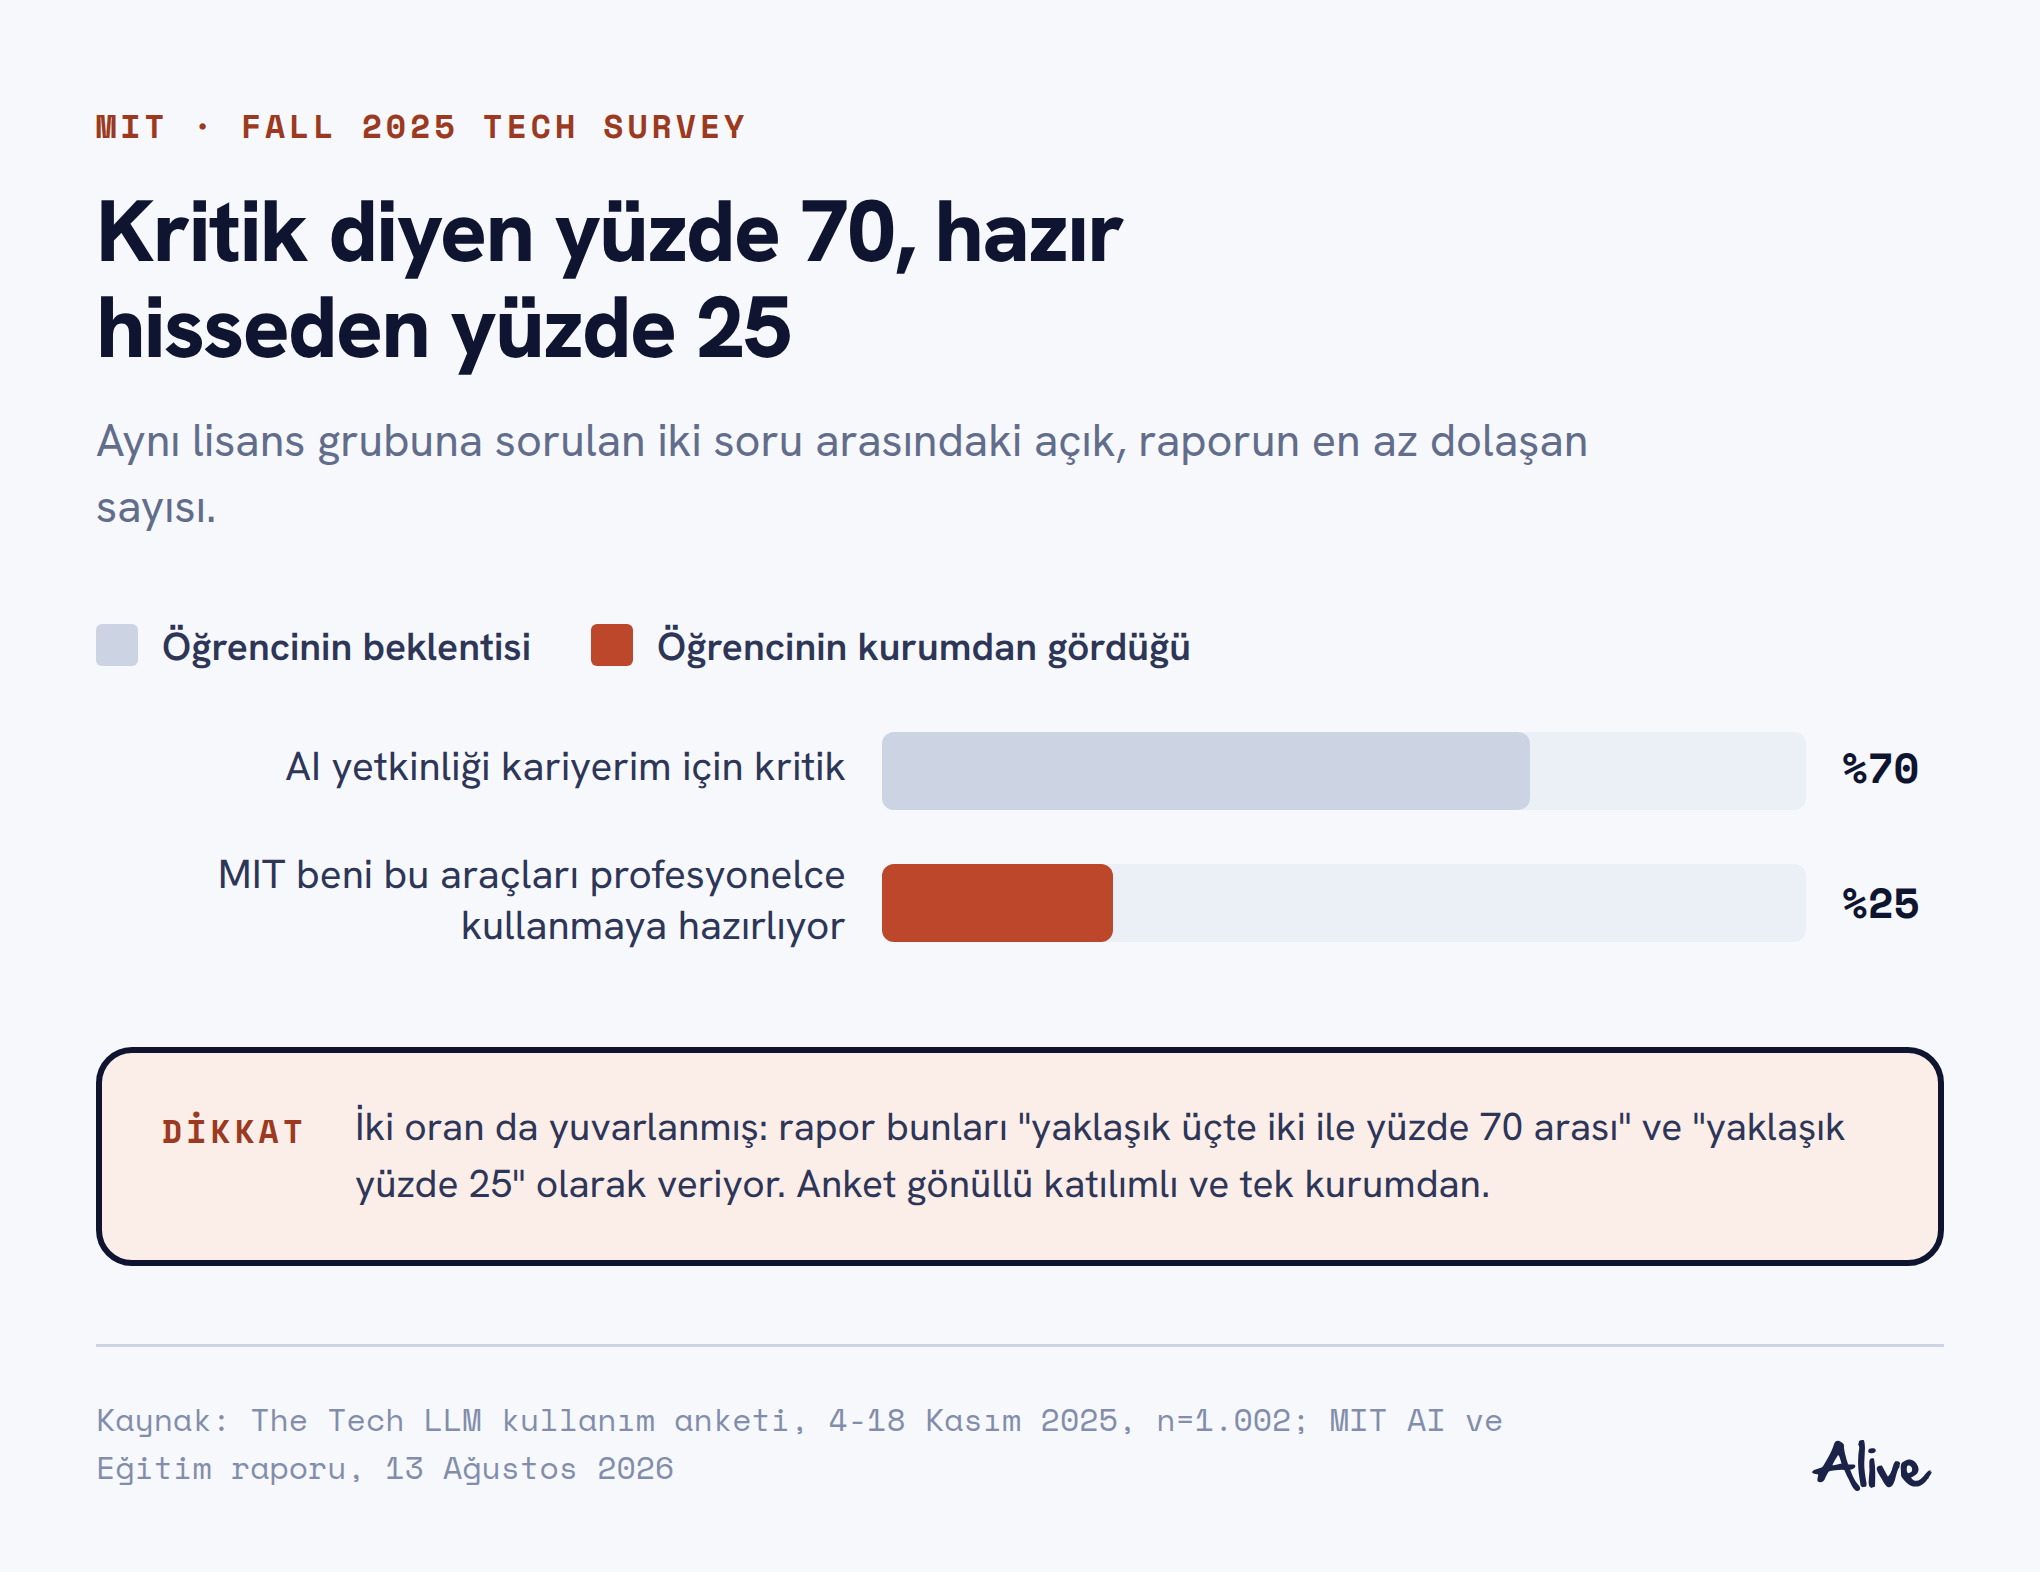
Rapor bu boşluğu bir dürüstlük anı olarak kullanıyor: kurum öğrencisine hem "bunu kullanma" hem "bunu bilmeden mezun olma" diyemiyor. Kaygı tarafı da özetlerde sıkışmış. Tech anketinde lisans öğrencilerinin yüzde 90'ı aşırı bağımlılıktan bir miktar ya da çok endişeli; "çok endişeli" diyenler yüzde 67. Tek bir yüzde 90 olarak dolaştığında endişenin şiddeti kayboluyor.
İki cephe: format çözer mi, ölçeklenir mi
Format değişirse sorun çözülür
- Kopya çıktının üzerinden yapılıyor; ölçmeyi çıktıdan alıp sürece taşıyınca kopyanın yapacak işi kalmıyor.
- Dedektör yanlış pozitif üretiyor ve bunu en çok ana dili İngilizce olmayanlara yapıyor; insan hakemi bu hatayı yapmıyor.
- Format yeni de değil: @clarasingsart konservatuvarların yüzyıllardır sözlü ölçtüğünü hatırlatıyor, adı resital.
Format değişse de ölçeklenmez
- @AGILoading matematiği yapıyor: öğrenci başına 20 dakikalık bir sözlü, ders başına yüzlerce sınav saati demek. Kimse o saati bugün harcamıyor.
- @Ysqander'a göre sözlü sınav öğrencinin AI ile nasıl çalıştığını ölçmüyorsa yanlış şeyi ölçüyor: matematikçiden dört işlem istemek gibi.
- Her derse zorunlu sosyal bileşen herkese aynı maliyeti çıkarmıyor; @akuma_1997 bunu kısaca "içedönükler için cehennem" diye özetliyor.
Üçüncü okuma: Batı kendi attığını geri alıyor
Tartışmanın en çok gözden kaçan tarafı coğrafi. Sözlü sınav, jüri önünde savunma ve dönem projesi Türkiye'de de, Doğu Avrupa'da da hiç gitmedi. @visokodrustvo eski Yugoslavya sisteminde sözlü sınavın standart olduğunu hatırlatıyor; aynısını burada bitirme jürisi için söyleyebilirsin. Yani MIT'in bulduğu şey yeni bir yöntem değil. Yeni olan, yöntemi ceza olarak değil tasarım olarak kurması: sözlü sınav kopyayı yakalamak için değil, öğrenmenin gerçekleştiği yeri ölçmek için var.
İkinci sapma notun kendisinde. @juliette_hiyb GPA'i Goodhart yasası üzerinden okuyor: not öğrenmeyi ölçmek için konulmuştu, ölçüt haline geldiği anda hedef oldu ve öğrenme hedef olmaktan çıktı. Komite raporu bunu daha kibar söylüyor ama aynı yere bakıyor.
Bir de dolaşımdaki özetin uydurduğu bir bulgu var. "AI'ın kendilerini yeri doldurulabilir hissettirdiğini söyleyen lisans öğrencileri, yetkin hissettirdiğini söyleyenleri geçti" cümlesi çok paylaşıldı. Anket bunu sormadı. Yakın duran veri, kariyer kritikliği ile hazır hissetme arasındaki boşluk; o da aynı şey değil.
Üç anketin üçü de gönüllü katılıma dayanıyor, yani kendini seçen bir örneklem. Tech anketi ağırlıklandırılmamış ve lisansüstü tarafı Makina ile Havacılık ağırlıklı, EECS ile Matematik düşük temsilli. AI Usage anketinin dönüş oranı yüzde 12. Hepsi tek bir kurumdan geliyor: MIT. Bu rapor bir üniversitenin kendi öğrencisine dürüst bakışı, dünyanın ortalaması değil. Türkiye'deki bir bölüme ya da bir şirketin eğitim programına doğrudan taşınmaz.
Bizim duruşumuz
Tartışma "kopya nasıl engellenir" diye kuruluyor ve iki taraf da bu soruya cevap veriyor. Bir taraf gözetimi sıkalım diyor, diğer taraf formatı değiştirelim. İkisi de yarı haklı, ama soru yanlış yerde duruyor.
Asıl soru şu: çıktı kanıt olmaktan çıktıysa yeterliliği neyle gösteriyorsun?
Bu okulun sorusu değil. İşe alımın sorusu: portfolyodaki ekran görüntüsü artık kimin yaptığını söylemiyor. Terfinin sorusu: teslim edilen dokümanın arkasında hangi karar var, bilmiyorsun. Eğitim tarafının sorusu: sertifikanın anlattığı şey ile insanın yapabildiği şey arasındaki mesafe açılıyor.
MIT'in cevabı ilginç olduğu için değil, maliyeti kabul ettiği için ciddiye alınmalı. Sözlü sınav pahalı. Portfolyo okumak pahalı. Komite bunu biliyor ve yine de yazılım yerine insan saati seçiyor. Bu bir konfor kararı değil, bir bütçe kararı. Aynı kararı biz de veriyoruz: Brick'te bir eğitimin çıktısı sertifika değil proje, ama "bu projeyi gerçekten sen mi kurdun" sorusunun cevabı bizde de otomatik gelmiyor. Yüz yüze bileşen ve topluluk formatı o boşluğu kapatmak için var, ve o boşluk hala açık.
Bunu bu hafta deneyebilirsin: bir işe alım görüşmesinde ya da bir teslim değerlendirmesinde çıktıya değil, çıktının nasıl oluştuğuna bak. On beş dakika yeter. Hangi kararı neden verdin, nerede tıkandın, neyi denedin ve attın, hangi kısmı hala açıklayamıyorsun. Anlatılamayan çıktı artık kanıt sayılmıyor, bunu bir kural olarak yazmak zorunda bile değilsin: soru sormaya başladığın anda kural kendiliğinden kuruluyor.
Senin ekibinde birinin bir işi gerçekten yapabildiğini nereden anlıyorsun: teslim ettiği şeyden mi, o şeyi anlatışından mı? MIT'in raporu bir eğitim raporu gibi duruyor ama aslında bir kanıt raporu, ve o soru okuldan çok daha geniş bir yeri ilgilendiriyor. 🧱