Performans değerlendirmende yeni bir satır var: AI yetkinliği. Asıl soru, o satırın neyi saydığı.
24 Eylül'de Aakash Gupta, The Growth Podcast'te Zapier'in kurucusu ve CEO'su Wade Foster'ı konuk etti. Bölümün kurgusu basit: Aakash kendi hazırladığı üç PM işini ekrana getiriyor, Wade de her birini Zapier'in AI yetkinlik tablosuna (İngilizce adıyla AI Fluency Rubric) göre canlı notluyor.
Tablo yeni değil. Zapier ilk sürümünü Mayıs 2025'te açık kaynak olarak paylaştı, ikincisini 31 Mart 2026'da. Yeni olan, bu tür çerçevelerin işe alım masasından çıkıp performans değerlendirmesine yerleşmesi. Wade'in anlatımına göre Zapier'de performans değerlendirmesi altı ayda bir yapılıyor ve AI seviyesi bu döngünün konusu.
Ekibinde "AI'ı ne kadar iyi kullanıyoruz" sorusu masadaysa, bu tablo şu an kamuya açık en olgun örnek. Ama bir tabloyu kopyalamak ile ondan ölçüm çıkarmak aynı şey değil.
İki yol denendi: kullanımı zorunlu kılmak ya da iyiyi tarif etmek
7 Nisan 2025'te Shopify CEO'su Tobi Lütke şirket içi notunu X'te kendisi paylaştı. Üç maddesinden biri netti: AI kullanımı performans değerlendirmelerine girecek. Aynı ay Duolingo "AI-first" olduğunu ve çalışanların AI kullanımıyla da değerlendirileceğini duyurdu.
Bir yıl sonra bu hattın iki durağı geri adım oldu. Meta'da bir çalışanın kurduğu, en çok token harcayanları sıralayan pano Nisan 2026'da kapatıldı. Aynı ay Duolingo CEO'su Luis von Ahn, AI kullanımını değerlendirme ölçütü olmaktan çıkardıklarını söyledi. Gerekçesi doğrudan ölçümle ilgili: çalışanlar asıl sonuçtan değil, bazı işlere hiç uymayan bir şeyi kullanmaktan hesap verir hale gelmişti. Von Ahn'ın kısa özeti de şu: "Seni zorlamayacağım."

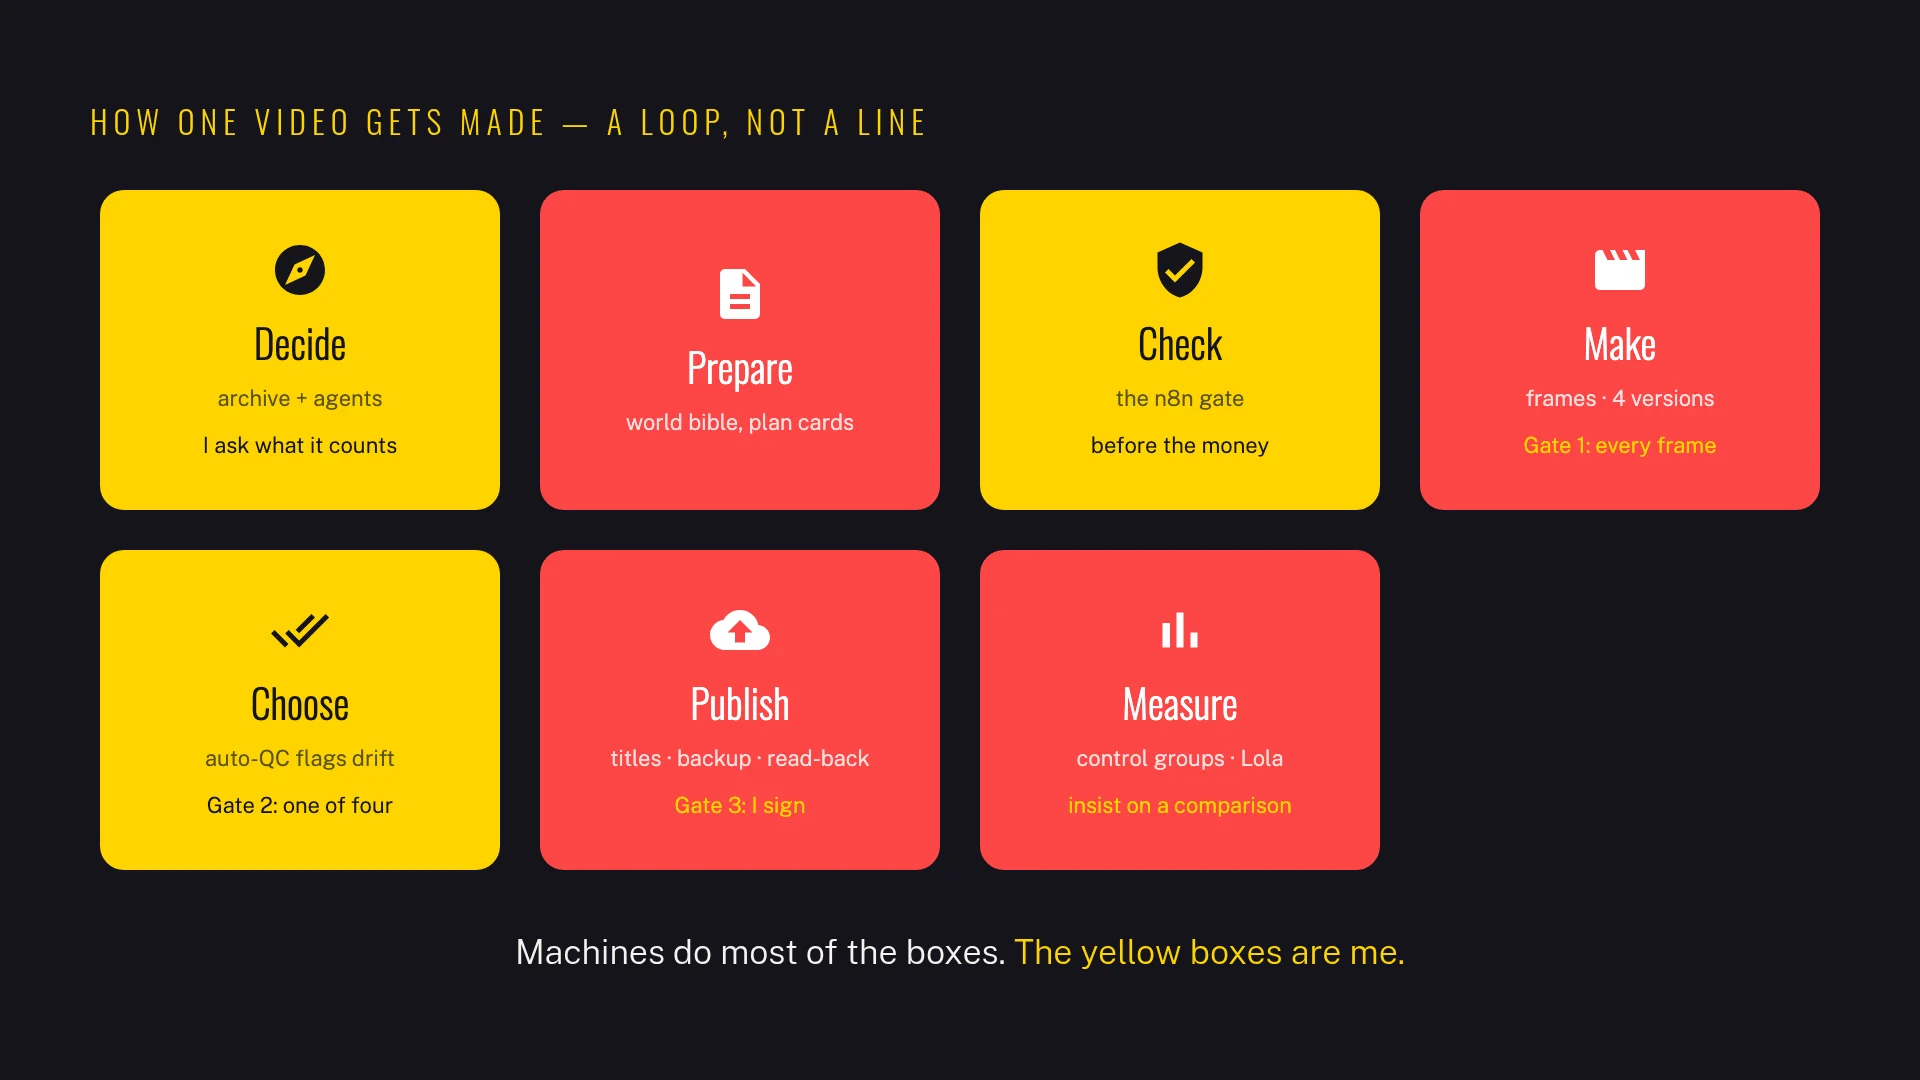
Zapier ikinci yolu seçti: kullanımı saymak yerine iyi işin neye benzediğini yazdı. İlk sürümün sorununu Wade şöyle tarif ediyor: "V1 yalnızca kullanıma bakıyordu. AI'da zemin sürekli kayıyor." İkinci sürüm bu yüzden ne kadar kullandığını değil, ne kurduğunu soruyor.
Zapier'in yetkinlik tablosu: dört seviye, dört bileşen
Tablo her rolü dört seviyeye ayırıyor. Unacceptable işe alınmıyor. Capable asgari çıta: "AI ile belirgin biçimde daha üst seviyede çalışıyorum." Adoptive: "AI'ı yönetiyor, işimi yükselten sistemler kuruyorum." Transformative: "İşin nasıl yapıldığını yeniden tasarlıyorum."
Her seviyede aynı dört bileşene bakılıyor: AI zihniyeti (mindset), strateji, inşa (building) ve V2 ile eklenen sorumluluk (accountability). Tablo mühendislikten hukuka, satıştan finansa on üç ayrı rol için ayrı satır yazıyor. Aşağıda PM ve tasarımcıların satırı var.
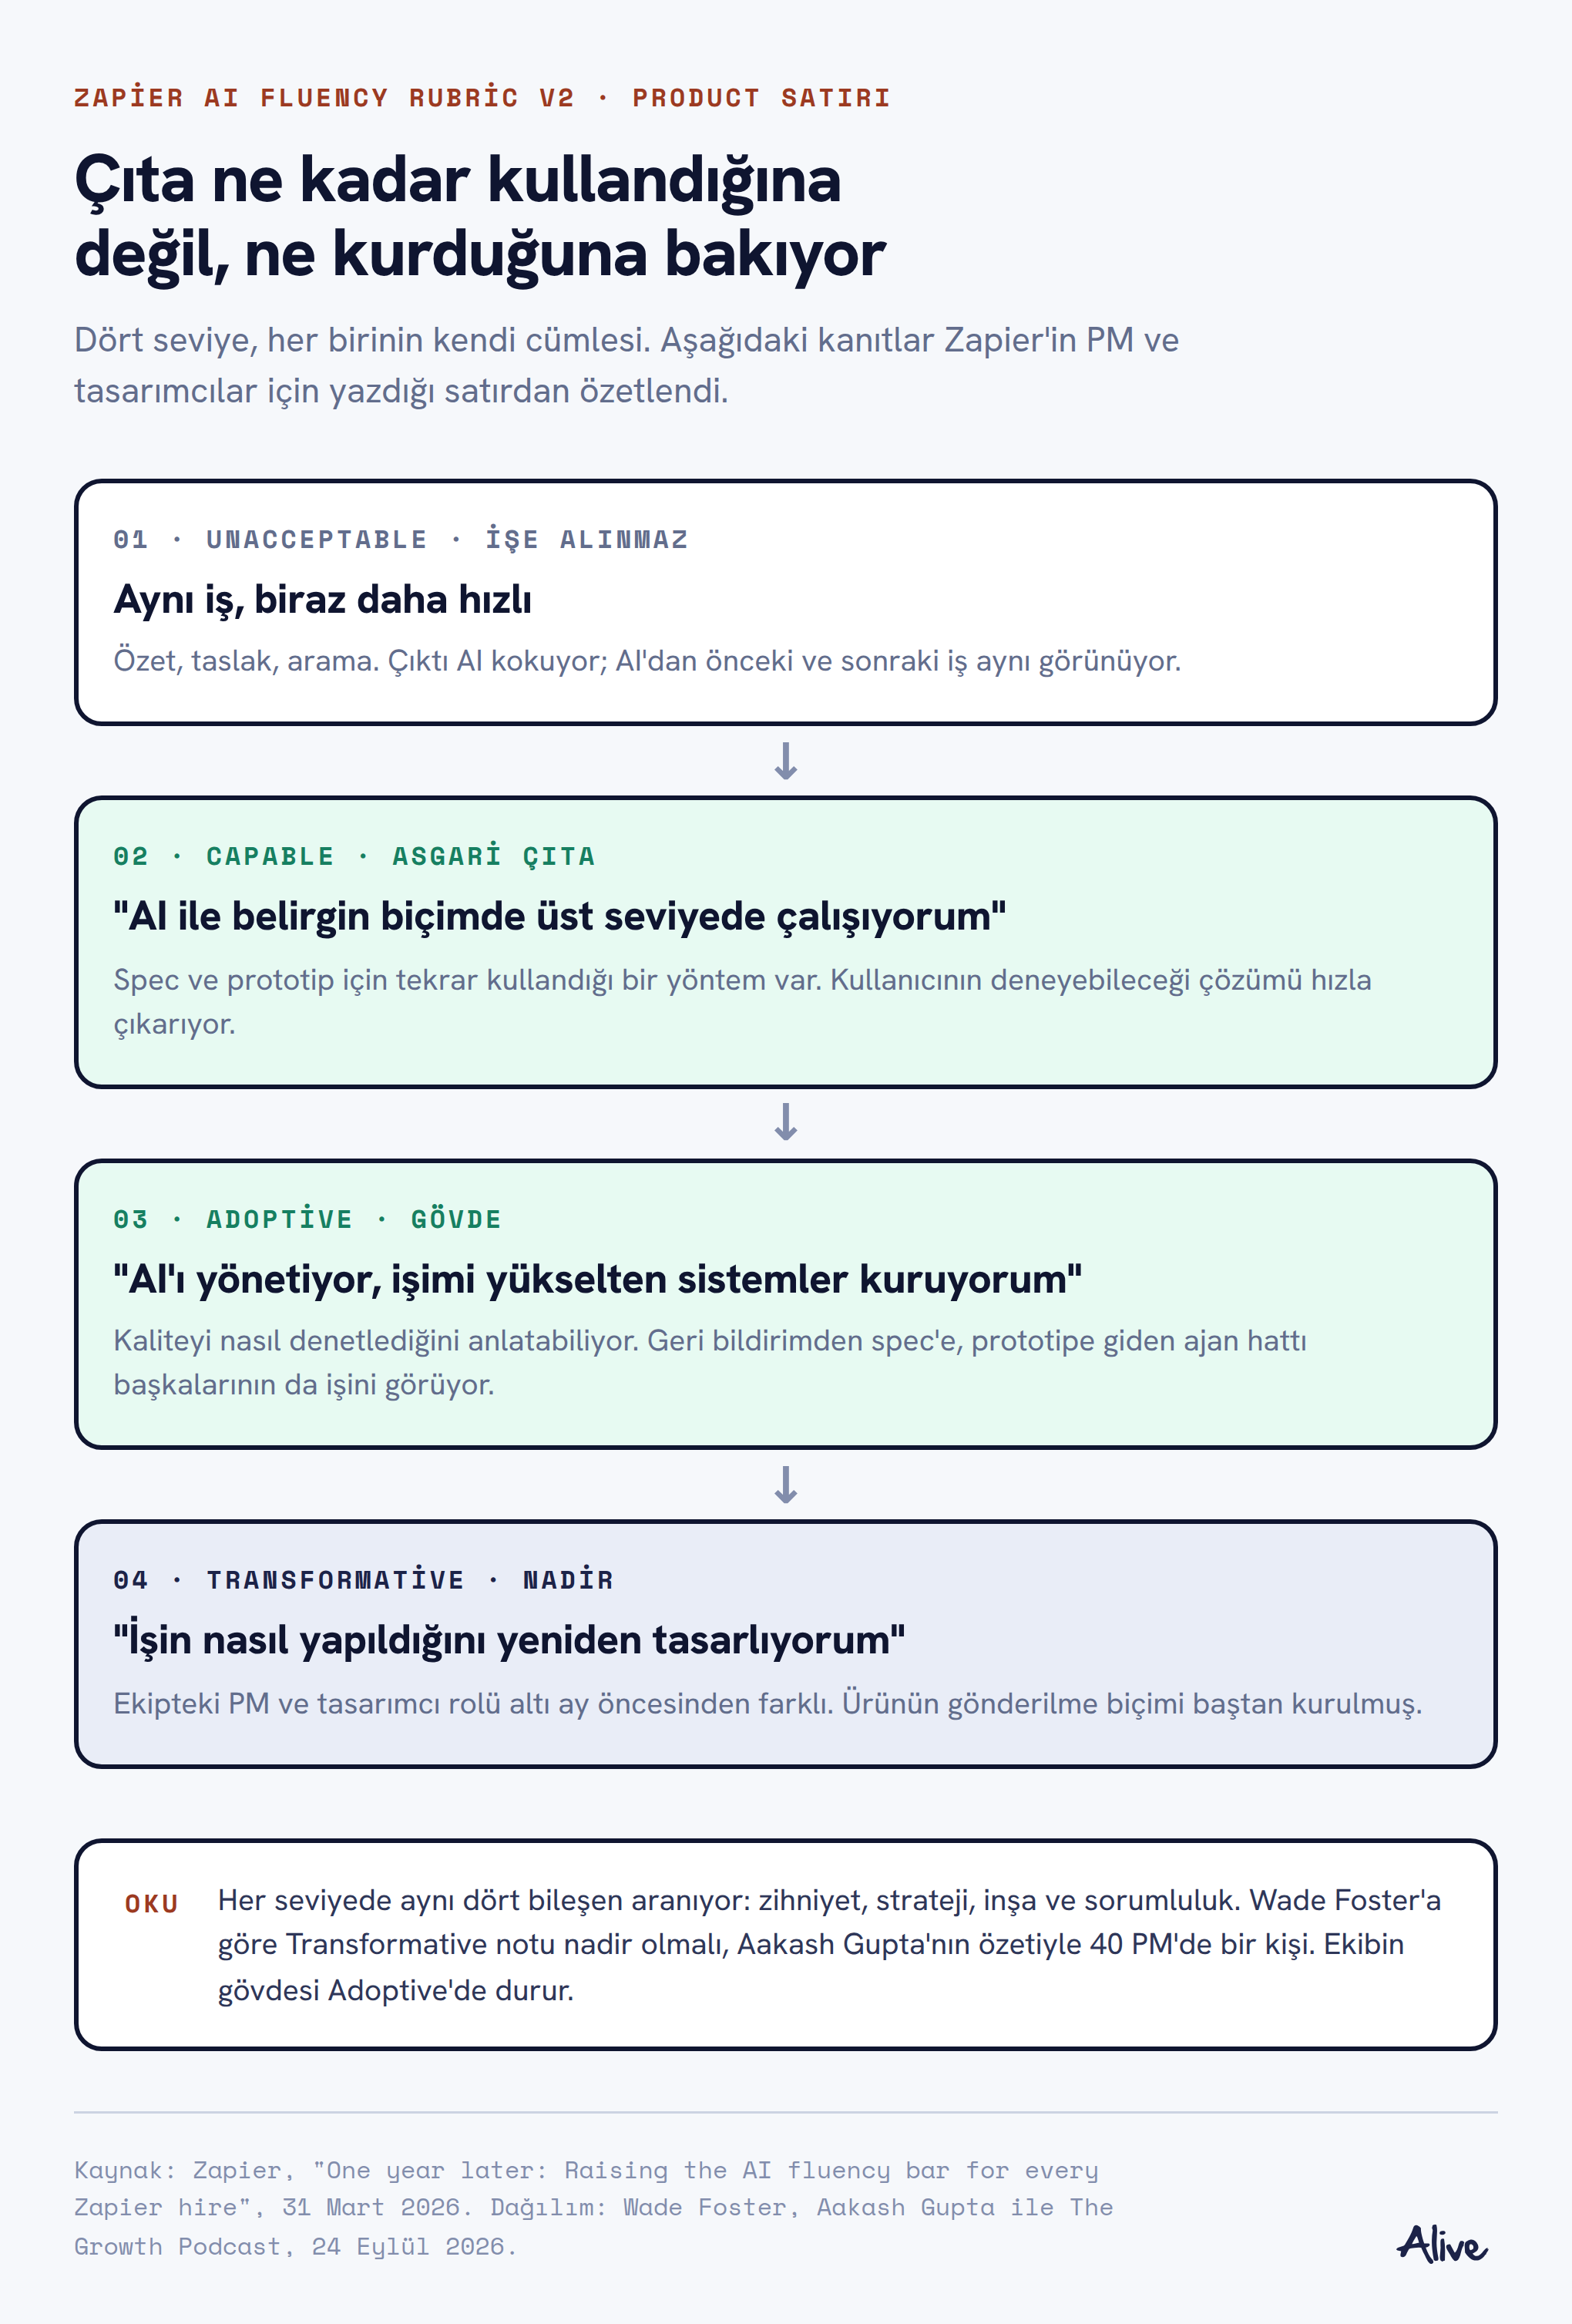
En öğretici satır Unacceptable. Özet çıkarmak, taslak yazmak, bilgi aramak için AI kullanan biri Zapier'de işe alınmıyor; not "yaptığı bunlardan ibaretse" diye düşülmüş. Yani çoğu şirketin "biz AI kullanıyoruz" diye saydığı davranış, bu tabloda sıfır noktası.
V2'yi ölçüm aracına çeviren dört karar
İkinci sürümde dört değişiklik var ve dördü de "ne kullanıyorsun" sorusundan "ne gösterebiliyorsun" sorusuna kayıyor.
| Karar | Ne istiyor | Ölçüme etkisi |
|---|---|---|
| Çıta yükseldi | İşin çekirdeğine gömülü AI, tek seferlik prompt değil tekrarlanan sistem, kalite ya da verimde net etki | Beyan yetmiyor, önce ve sonra örneği isteniyor |
| Gidişat (slope) | Nereden başladın, neyi denedin ve bıraktın, yaklaşımın nasıl değişti | Anlık fotoğraf yerine eğri okunuyor |
| Sorumluluk | "İyi"yi baştan tanımlamak, çıktıyı eleştirel okumak, hatayı göndermeden yakalamak | Hızın yanına kalite kapısı giriyor |
| Canlı beceri testi | Adayı AI ile çalışırken izlemek: nasıl prompt yazıyor, çıktıya nasıl itiraz ediyor, nasıl uyarlıyor | Cilalı sonuç yerine süreç notlanıyor |
Yöneticiler için ayrı bir çıta da var. Kişisel olarak akıcı ama ekibi hala eski usulde çalışan bir yönetici çıtayı geçmiyor; yöneticiden ekibin iş akışını AI ile yeniden tasarladığını göstermesi bekleniyor.
AI ile işi devredebilirsin, sorumluluğu devredemezsin.
Zapier, AI Fluency Rubric V2, 31 Mart 2026Canlı testin arkasında bir veri de var. Zapier, testi yeniden tasarlarken Anthropic'in AI Fluency Index'ine dayanıyor. 9.830 anonim Claude.ai konuşmasını inceleyen çalışmada, yineleyen ve düzelten konuşmalarda ortalama 2,67 akıcılık davranışı görülüyor; tek seferlik konuşmalarda 1,33. Zapier'in bundan çıkardığı sonuç açık: güçlü akıl yürütme ve gerçek yinelemeyle gelen kaba bir sonuç, arkasında görünür süreç olmayan cilalı bir sonuçtan daha iyi sinyal.
Canlı notlama: üç PM işi, üç seviye
| İş | Seviye | Wade'in notu |
|---|---|---|
| ChatGPT ile yazılmış, düzgün formatlı bir PRD (ürün gereksinim dokümanı) | Capable | Prototip yok, müşteri kanıtı yok. "Benim bildiğim ama senin bilmediğin şeyler varsa bu pek iyi bir sinyal değil." |
| Kanıta dayanan bir PRD ve çalışan bir prototip, Claude Code ile kurulmuş bir PM iş akışından | Adoptive | İlk işte eksik olan iki şey de kapanmış. |
| Tekrarlayan işi skill'lere yazan, alt ajanlarla paralel inceleme yapan, müşteri sinyalini doğrudan okuyan ve iki insan onay kapısı olan bir ekip işletim modeli | Transformative | "Bu, üç yıl önce ürün ve yazılımın yapıldığı biçim değil. Yakından bile değil." |
Bölümün en ilginç kısmı notlar değil, dağılım. Wade'e göre Transformative notu nadir olmalı. Otuz-kırk kişilik bir PM ekibinde bir değerlendirme döneminde kaç kişinin alacağı sorulunca cevabı "muhtemelen düşük bir yüzde" oluyor; Aakash bunu 40 PM'de bir kişi diye özetliyor. Wade'in beklediği, ekibin gövdesinin Adoptive'de durması. Üstelik sürekli Transformative seviyede çalışmayı bir uyarı işareti sayıyor: "Öyleysen aslında iş bitirmiyorsundur."
Wade zeminin kaydığını da söylüyor: 2024'te Transformative sayılan iş, 2026'da Adoptive. Yani bu tablo sabit bir yetkinlik belgesi değil, zamana ve ekibe göre değişen bir sıralama.
Tablonun göremediği üç şey
Tablo çok paylaşıldı ve birçok şirket kendi versiyonunu çıkardı. Ama üç yerde eksik kalıyor.
- Öğretmek kenarda kalıyor. Bethany Crystal'a göre "öğretmek" tabloda açıkça yalnızca People ekibinin en üst seviyesinde geçiyor ve bunu kısa görüşlülük olarak görüyor: "Yetkin bir AI öğrencisinin bugün yapabileceği en değerli şey dönüp öğretmek." Satış ve veri satırlarında başkalarını hızlandırmak, enablement oturumu yapmak gibi örnekler var; ama bunlar ayrı bir ölçüt değil, seviye tariflerinin içinde birer örnek.
- Tasarımın kendi satırı yok. Product satırı PM ve tasarımcıyı birlikte anıyor. @felixleezd'nin yorumu kısa: "Tasarım nerede? PM'lerin içine çekilmiş." Oysa tasarımcının AI ile yaptığı iş, PM'inkinden farklı kanıt ister.
- Mevcut çalışanı nasıl notladığı görünmüyor. Zapier işe alımdaki dört durağı (başvuru, ön görüşme, beceri testi, yönetici mülakatı) ayrıntılı anlatıyor. Çalışanlar için ise blog yazısında tek bir cümle var: performans beklentileri artık "işimizi AI ile nasıl yükselttiğimizi" de içeriyor. Kimin, hangi kanıtla notladığı açık değil. Tablodaki cümleler de kolay kopyalanıyor; canlı gözlem olmadan bir özgeçmiş ya da öz değerlendirme aynı cümleleri tekrar edebilir.
Tablo yetkinliği ölçmez, neye bakacağını söyler. Ölçüm, ekibin ürettiği işte yapılır.
Kendi ekibinde AI yetkinliğini nasıl ölçersin
Zapier'in tablosunu sözlük olarak kullan, ölçümü kendi işinden kur. Önce neyi saymayacağına karar ver.

1. Rolü seç, satırı kendi işinle yaz
Zapier'in on üç satırı bir başlangıç, hedef değil. Her rol için dört seviyeyi kendi ekibinden gerçek bir örnekle doldur. Tasarım, araştırma ya da içerik gibi tabloda kendi satırı olmayan rolleri ayrı yaz; PM satırına sıkıştırma.
2. Beyan değil, artefakt iste
"Ne kadar kullanıyorsun" yerine "göster" de. Aylara yayılan bir önce ve sonra örneği, tekrar kullanılan bir iş akışı, ekipte başkasının kullandığı bir şablon ya da ajan. Gösterilemeyen yetkinlik, bu ölçümde henüz yok sayılır.
3. Sonucu değil süreci izle
Yarım saatlik canlı bir oturum yeter: kişi gerçek bir işini AI ile yaparken nasıl bağlam veriyor, çıktıya nerede itiraz ediyor, neyi atıyor. Yukarıdaki veri de aynı şeyi söylüyor: parlak sonuç tek başına kanıt değil.
4. Emek etiketini ekip normu yap
Zapier'de AI ile hazırlanan iş, ne kadar emek girdiğini söyleyen bir cümleyle paylaşılıyor: "AI ile taslak çıkardım, hızlıca göz attım" ya da "Her cümlenin arkasındayım." Wade'e göre etiketsiz ham çıktı "işi bana yaptırmak" demek. Bu norm sorumluluk bileşenini görünür kılar, yöneticiyi de ham çıktının editörü olmaktan kurtarır.
5. Gidişatı oku, dağılımı dürüst tut
Aynı kişiye altı ay sonra tekrar bak; not değil eğri önemli. Üst seviyeyi nadir tut: ekibin yarısı Transformative çıkıyorsa ölçmüyor, kutluyorsun. Yöneticiye de ayrı soru sor: kendi işin değil, ekibinin işi değişti mi?
6. Öğretmeyi ölçüte ekle
Adoptive ve üstü için tek bir soru daha: senin kurduğun şey başkasının işini ne değiştirdi? Zapier'in tablosunda bu, bazı satırlarda örnek olarak geçiyor. Kurum içinde yayılmanın asıl motoru bu olduğu için onu ayrı bir ölçüt olarak yazmanı öneriyoruz.
Tablo ve "%100 benimseme" rakamı Zapier'in kendi beyanı; bağımsız bir doğrulaması yok. Zapier otomasyon ve ajan ürünleri satıyor. Tablo aynı zamanda bu ürünlere talep yaratan bir çerçeve. Canlı notlama bir podcast bölümü: üç işi Aakash hazırladı, kontrollü bir değerlendirme değil. Anthropic verisi de iş yerindeki yetkinliği değil, Claude.ai konuşmalarındaki davranışı ölçüyor.
Soru "kullanılsın mı" değil, "neyi kanıt sayıyorsun"
Tartışma çoğu zaman "AI kullanımı performansa girsin mi" sorusunda sıkışıyor. Duolingo'nun geri adımı ve Meta'nın kapanan panosu bu sorunun yanlış kurulduğunu gösteriyor. Kullanımı zorunlu kılarsan insanlar kullanır; bu, işin iyileştiği anlamına gelmez.
Zapier'in tablosu kullanım saymadığı için işe yarıyor. Ama bir tablo ölçümün kendisi değil, sözlüğü. Sözlüğü kopyalayıp ölçtüğünü sanan kurum Duolingo'nun düştüğü yere başka bir kapıdan düşer: insanlar bu sefer tablodaki cümleye benzemek için çalışır.
Eğitim tasarlarken biz de aynı sırayı izliyoruz: AI yetkinliği araç bilgisiyle değil, işin tarifiyle başlıyor. Bir ekip kendi rolünde "iyi"nin neye benzediğini yazabildiğinde, hangi aracı öğreneceği kendiliğinden netleşiyor. Tersinden gidildiğinde elde bir lisans raporu ve dağınık promptlar kalıyor.
Bu tarifi ekibinle birlikte çıkarmak istersen, Brick'in kurumsal eğitimleri tam bu noktadan başlıyor. Yapay Zeka Okuryazarlığı ortak zemini kuruyor; Yapay Zeka ile Prototipleme ve Yapay Zeka Ajanları 101 ise tablodaki Adoptive seviyesinin istediği pratiğe, yani tekrar kullanılan sistem kurmaya geçiyor. Programı rollere ve ekibin bugünkü seviyesine göre uyarlıyoruz; önce "iyi"yi birlikte yazıyor, sonra aracı seçiyoruz.
Bu hafta ekibinden üç kişiye aynı soruyu sor: "Son üç ayda AI ile kurduğun ve hala kullandığın bir şeyi göster." Cevaplar arasındaki fark, kendi tablonu yazmadan önceki ilk ölçümün olur.
Senin ekibinde AI yetkinliği şu an neyle ölçülüyor: lisans raporuyla mı, gösterilebilen işle mi? Kullanımı saymak yalnızca başlangıç ölçümü; yetkinlik, gösterebildiğin işte başlar. 🧱