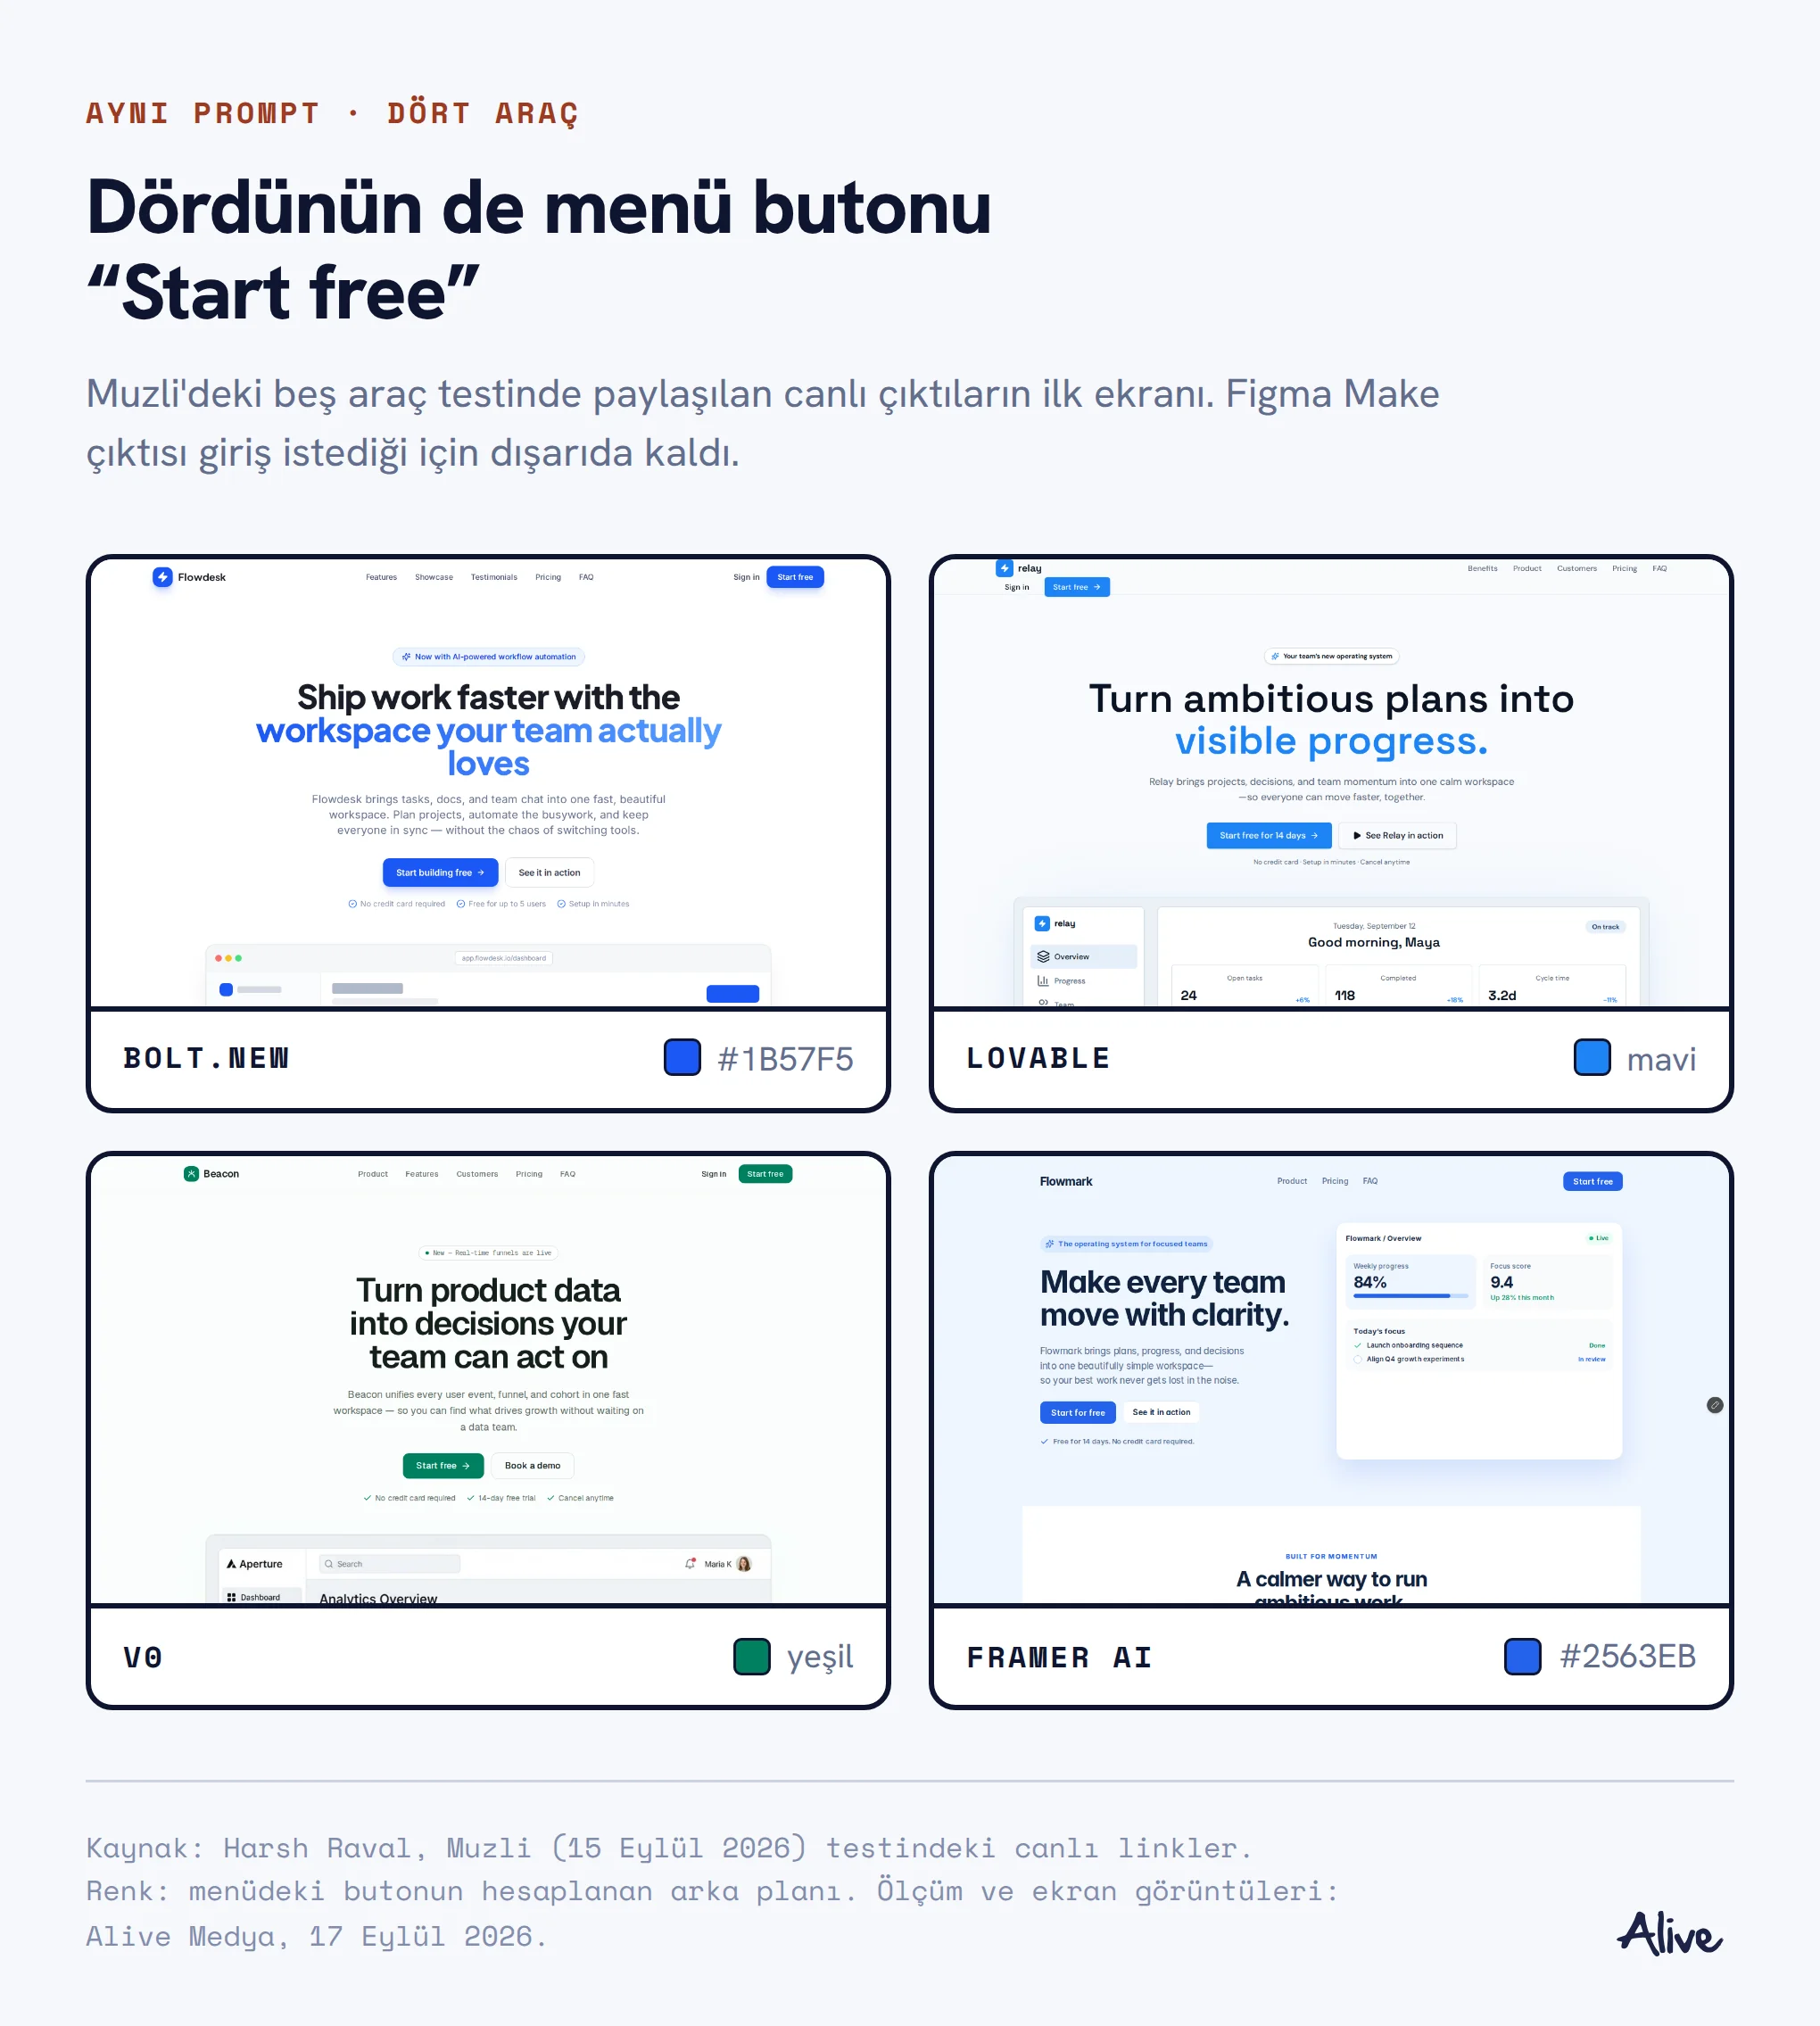
Beş AI prototipleme aracına aynı landing page prompt’unu veren bir test yazısındaki canlı linkleri tek tek açtık. Dört sayfanın dördünde de menüdeki buton aynı şeyi söylüyordu: Start free.
Test, Harsh Raval’in 15 Eylül’de Muzli’de yayımladığı yazıdan. Figma Make, Bolt.new, Lovable, v0 ve Framer AI’ya aynı SaaS landing page brief’i verilmiş. Araçlar ilk çıktıya ve o çıktının ne kadar kolay düzeltilebildiğine göre değerlendirilmiş. Figma Make’in çıktısı giriş istediği için dışarıda kaldı, kalan dördünü biz ölçtük (bir test yazısını test ettiğimizin farkındayız).
Dördünde de “No credit card required” satırı var. Üçünde bu buton mavi. Framer’ınki birebir Tailwind’in yıllardır varsayılan mavisi, #2563EB. Fontlar farklı (Inter, DM Sans, Geist), ama iskelet neredeyse kopya: ortada rozetli bir başlık, altında iki buton, onun altında bir dashboard maketi. Lovable’ın üst menüsü masaüstü genişlikte dağılmış, o da ayrı bir konu.
Boş bir tuvalde araçları yarıştırınca aslında modellerin ortalamasını ölçmüş oluyorsun. Aynı gün yayımlanan iki yazı ise başka bir soru soruyor. Rishi Sharma, Claude Code, Codex CLI ve Cursor’ı tasarım sisteminin gerçekte nerede hayatta kaldığına bakarak kıyaslıyor. Yazısını da demodan iki sprint sonra kimsenin nereden geldiğini bilmediği 13 piksellik bir boşlukla açıyor. UX Planet’teki yazı da aynı web sayfasını Claude Design ve Figma AI ile ayrı ayrı tasarlıyor.
Peki bu soru neden şimdi soruluyor? Son üç haftada birbirinden habersiz on iki ekip, tasarım sistemini ajanların okuyabileceği, uyabileceği ve ihlal ettiğinde yakalanabileceği hale getirmek için bir şey yayımladı. Kıyaslamalar hala araçlara bakıyor; iş ise sessizce sistem tarafına kaymış durumda.
SeçkiÜç haftada on iki örnek
| Örnek | Ne yaptı | Neyi göstermeye çalışıyor |
|---|---|---|
| Bağlam · DHM Tokens (Dei) | Figma dosyasını açmadan token ve skill paketiyle SwiftUI ekranı kurdu | Ajanın tasarımı yorumlaması yerine kararları hazır alması |
| Bağlam · Dianne Alter | Bağlamı AGENTS.md, PRODUCT.md ve DESIGN.md dosyalarına ayırdı | Bileşen kütüphanesinin tek başına sistem olmadığı |
| Bağlam · Valet | Şirket sitesinden tasarım sistemi çıkarıp her ajanın kullanabileceği skill’e çeviriyor | Sistemin bir araca değil ajana ait olabileceği |
| Bağlam · Florence | Baştan ajana hazır kurulmuş bir tasarım sistemi, beta | Mevcut sistemlerin ajan için kurulmamış olduğu |
| Kısıt · Jared Palmer | Ajanlar için Tailwind yerine StyleX’i daha iyi buldu | Stil dilinin onu kimin yazdığına göre seçilmesi |
| Kısıt · Eivind Kjosbakken | Tüm UI elemanlarını tek klasöre topladı, dışını ajana yasakladı | Tutarlılığın sistemi daraltarak geldiği |
| Kısıt · Scribe Stylus | Dokümanları Markdown’a taşıdı, kapsamı %37’den %52’ye çıkardı | İnsan için yazılan dokümanın ajana da açılması |
| Kısıt · Lucet | Ret, düşük güven, tool çağrısı gibi durumları bileşen yaptı | Sistemin kapsamının AI durumlarına genişlemesi |
| Doğrulama · open-design-system-bench | Dört sistemde ajan çıktısını puanladı | Sistem sadakatinin ölçülebilir olduğu |
| Doğrulama · shadcn/lint | Ajan kuralı çiğneyince doğru varyantı gösteren linter | İhlalin mesajla birlikte düzeltilebildiği |
| Doğrulama · Design Review | Figma’da sistem kullanımını ve ham değerleri denetleyen eklenti | Denetimin tasarım tarafına da taşındığı |
| Doğrulama · /break skill’i (Jakub Krehel) | Bileşeni her durumda render edip açıklarını buluyor | Sistemin kenar durumlarda da sınanması |
Sistemi ajana okutmak
Dei’nin DHM denemesi bu grubun en somut örneği. Coding agent Figma dosyasını hiç görmemiş. Tasarım kararlarını token, bileşen, sayfa spesifikasyonu ve asset olarak taşıyan bir Swift paketiyle çalışmış; yanına da paketin nasıl okunacağını anlatan bir skill verilmiş. Sonuç, yazarın kendi tahminiyle yaklaşık %90 görsel benzerlik ve 30-45 dakikalık bir iş (bunun bir benchmark olmadığını da kendisi ayrıca yazıyor, ki bu dürüstlük az bulunuyor).
1 Eylül’de Dianne Alter, bileşen kütüphanenin artık tasarım sistemin olmadığını söyleyip bağlamı ayrı dosyalara bölüyor: ajanın her oturumda ilk okuduğu AGENTS.md, ürünü anlatan PRODUCT.md ve arayüze dokunmadan önce okunacak DESIGN.md. Valet bir adım öteye gidiyor. Kurumsal e-postayla kayıt olanın şirket sitesinden bir tasarım sistemi çıkarıyor ve bunu herhangi bir ajanın kullanabileceği bir skill olarak veriyor. Florence ise sıfırdan “ajana hazır” kurulmuş bir sistem olarak beta’ya çıktı.
Sistemi daraltmak
Burada ufak bir araya girelim. Kalıbın belki de en ilginç itirafı 24 Ağustos’ta geldi.
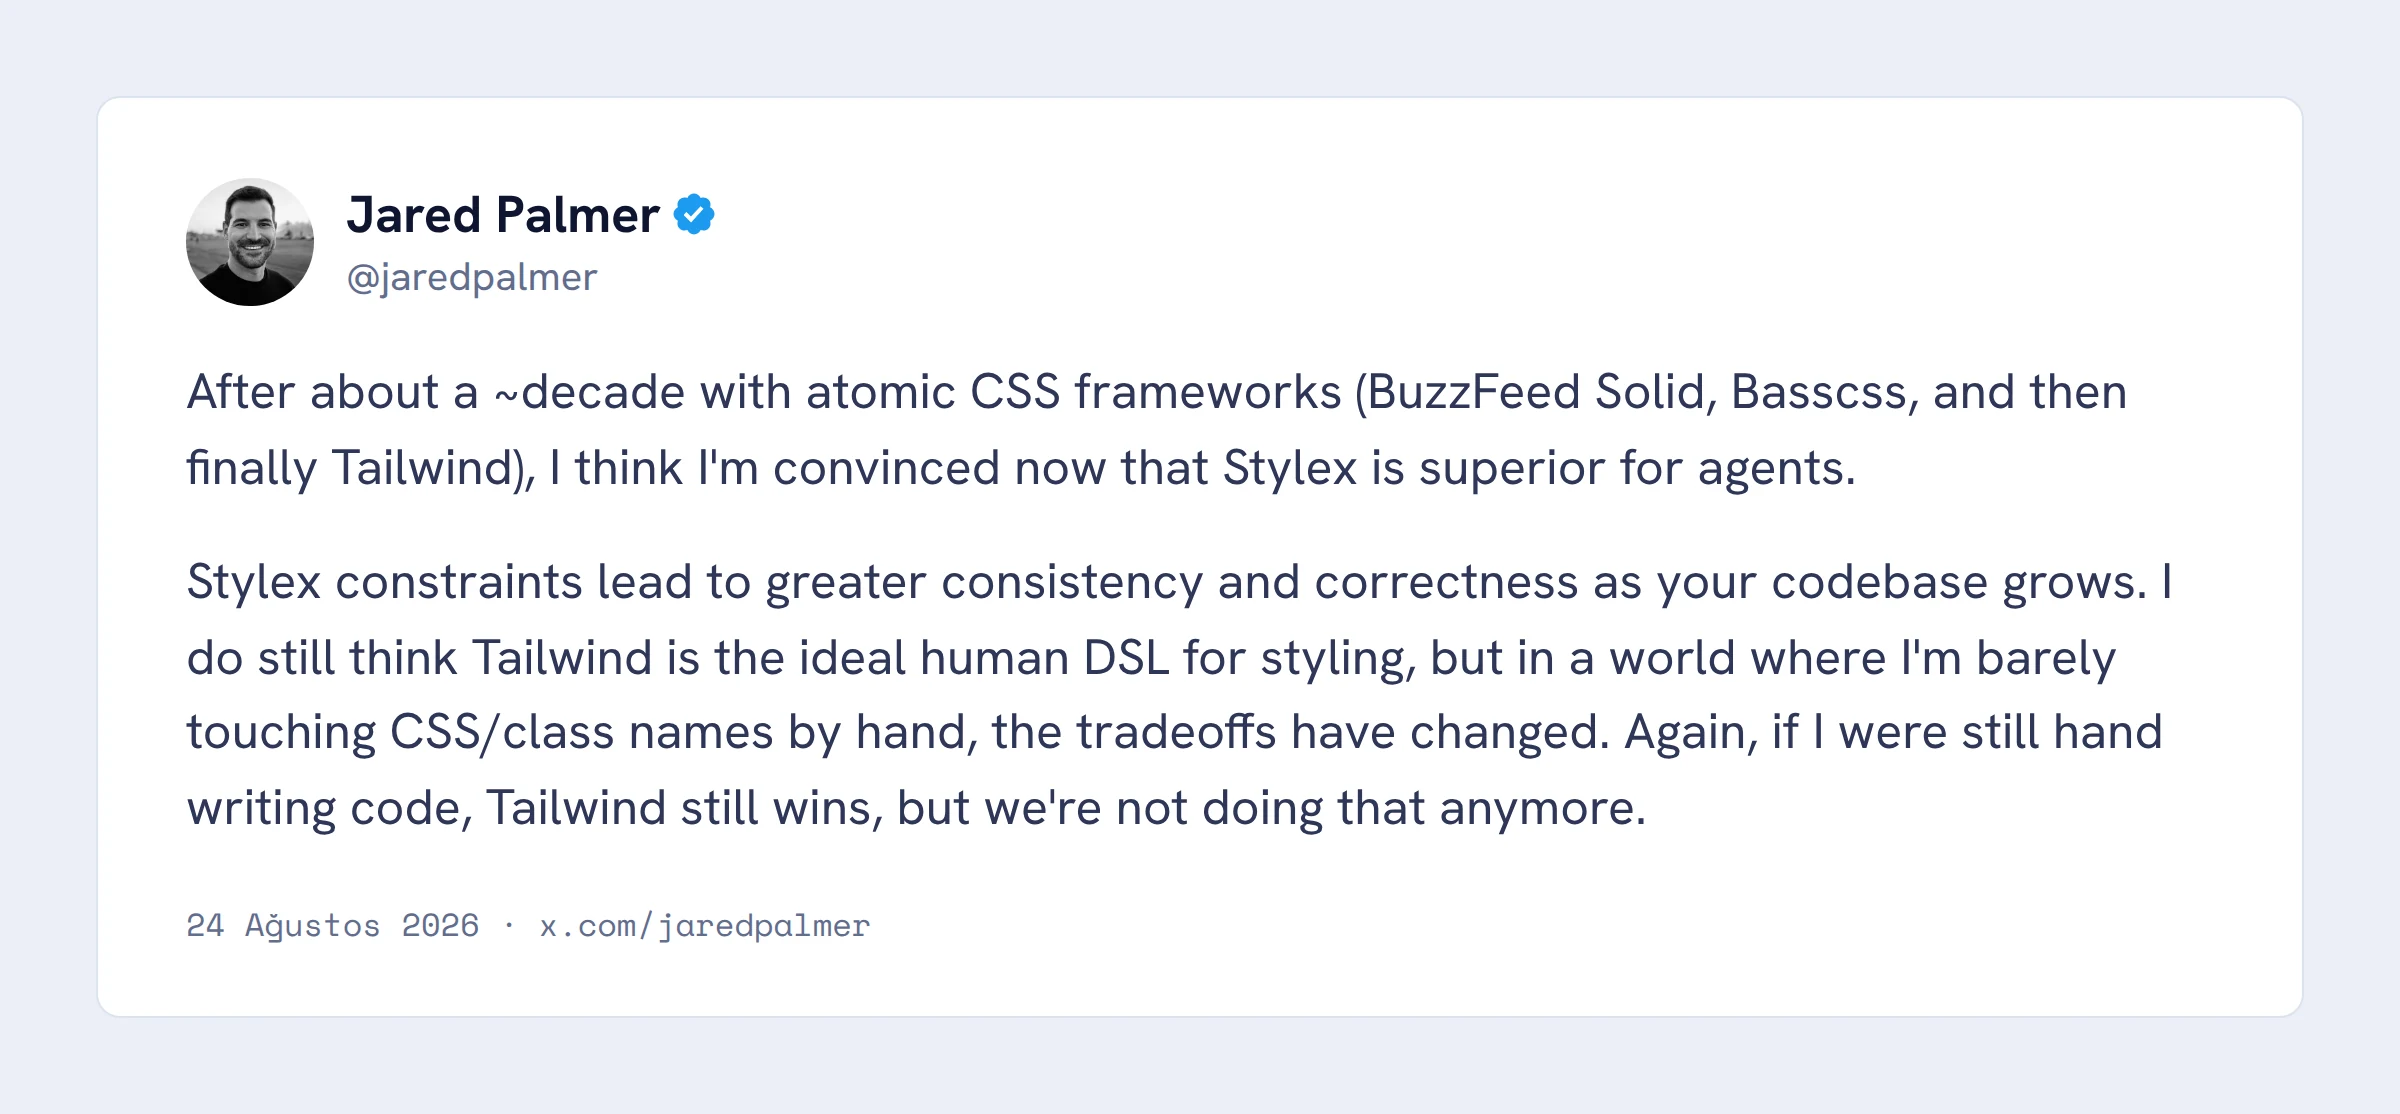
Turborepo’nun ve v0’ın arkasındaki isim, on yıl atomik CSS kullandıktan sonra ajanlar için StyleX’in daha iyi olduğuna ikna olmuş. Tailwind’i hala insan için ideal buluyor. Ama class adlarını artık elle yazmadığı bir dünyada dengelerin değiştiğini söylüyor. Yani stil dili, onu kimin yazdığına göre yeniden seçiliyor.
Eivind Kjosbakken’in 15 Eylül’deki Towards Data Science yazısı aynı şeyi küçük ölçekte söylüyor: tüm UI elemanlarını tek bir klasörde topla ve ajana o klasörün dışında yeni eleman üretmeyi açıkça yasakla. Scribe’ın tasarım sistemi Stylus’u 18 ay boyunca büyüten Ky Decker da dokümanları Markdown olarak kod tabanına taşıdığında ajanların erişiminin iyileştiğini yazıyor. İç ankette bir mühendis, AI kod araçlarının sistemi kullanmakta zorlanmadığını not etmiş (bir tasarım sistemi ekibinin duyabileceği en tatlı cümlelerden biri olabilir).
Lucet ise sistemin kapsamını genişletiyor. Ret, düşük güven, tool çağrısının kısmen başarısız olması, yedek modele geçiş gibi AI arayüzlerinde çoğu zaman unutulan durumları bileşen olarak tanımlıyor.
İhlali saymak
13 piksellik boşluğu hatırlıyorsun. shadcn/lint’in eval’lerinde ajanları sistem dışına itmek için verilen “günaha davet” görevlerinden biri de tam olarak bu: 13px padding.
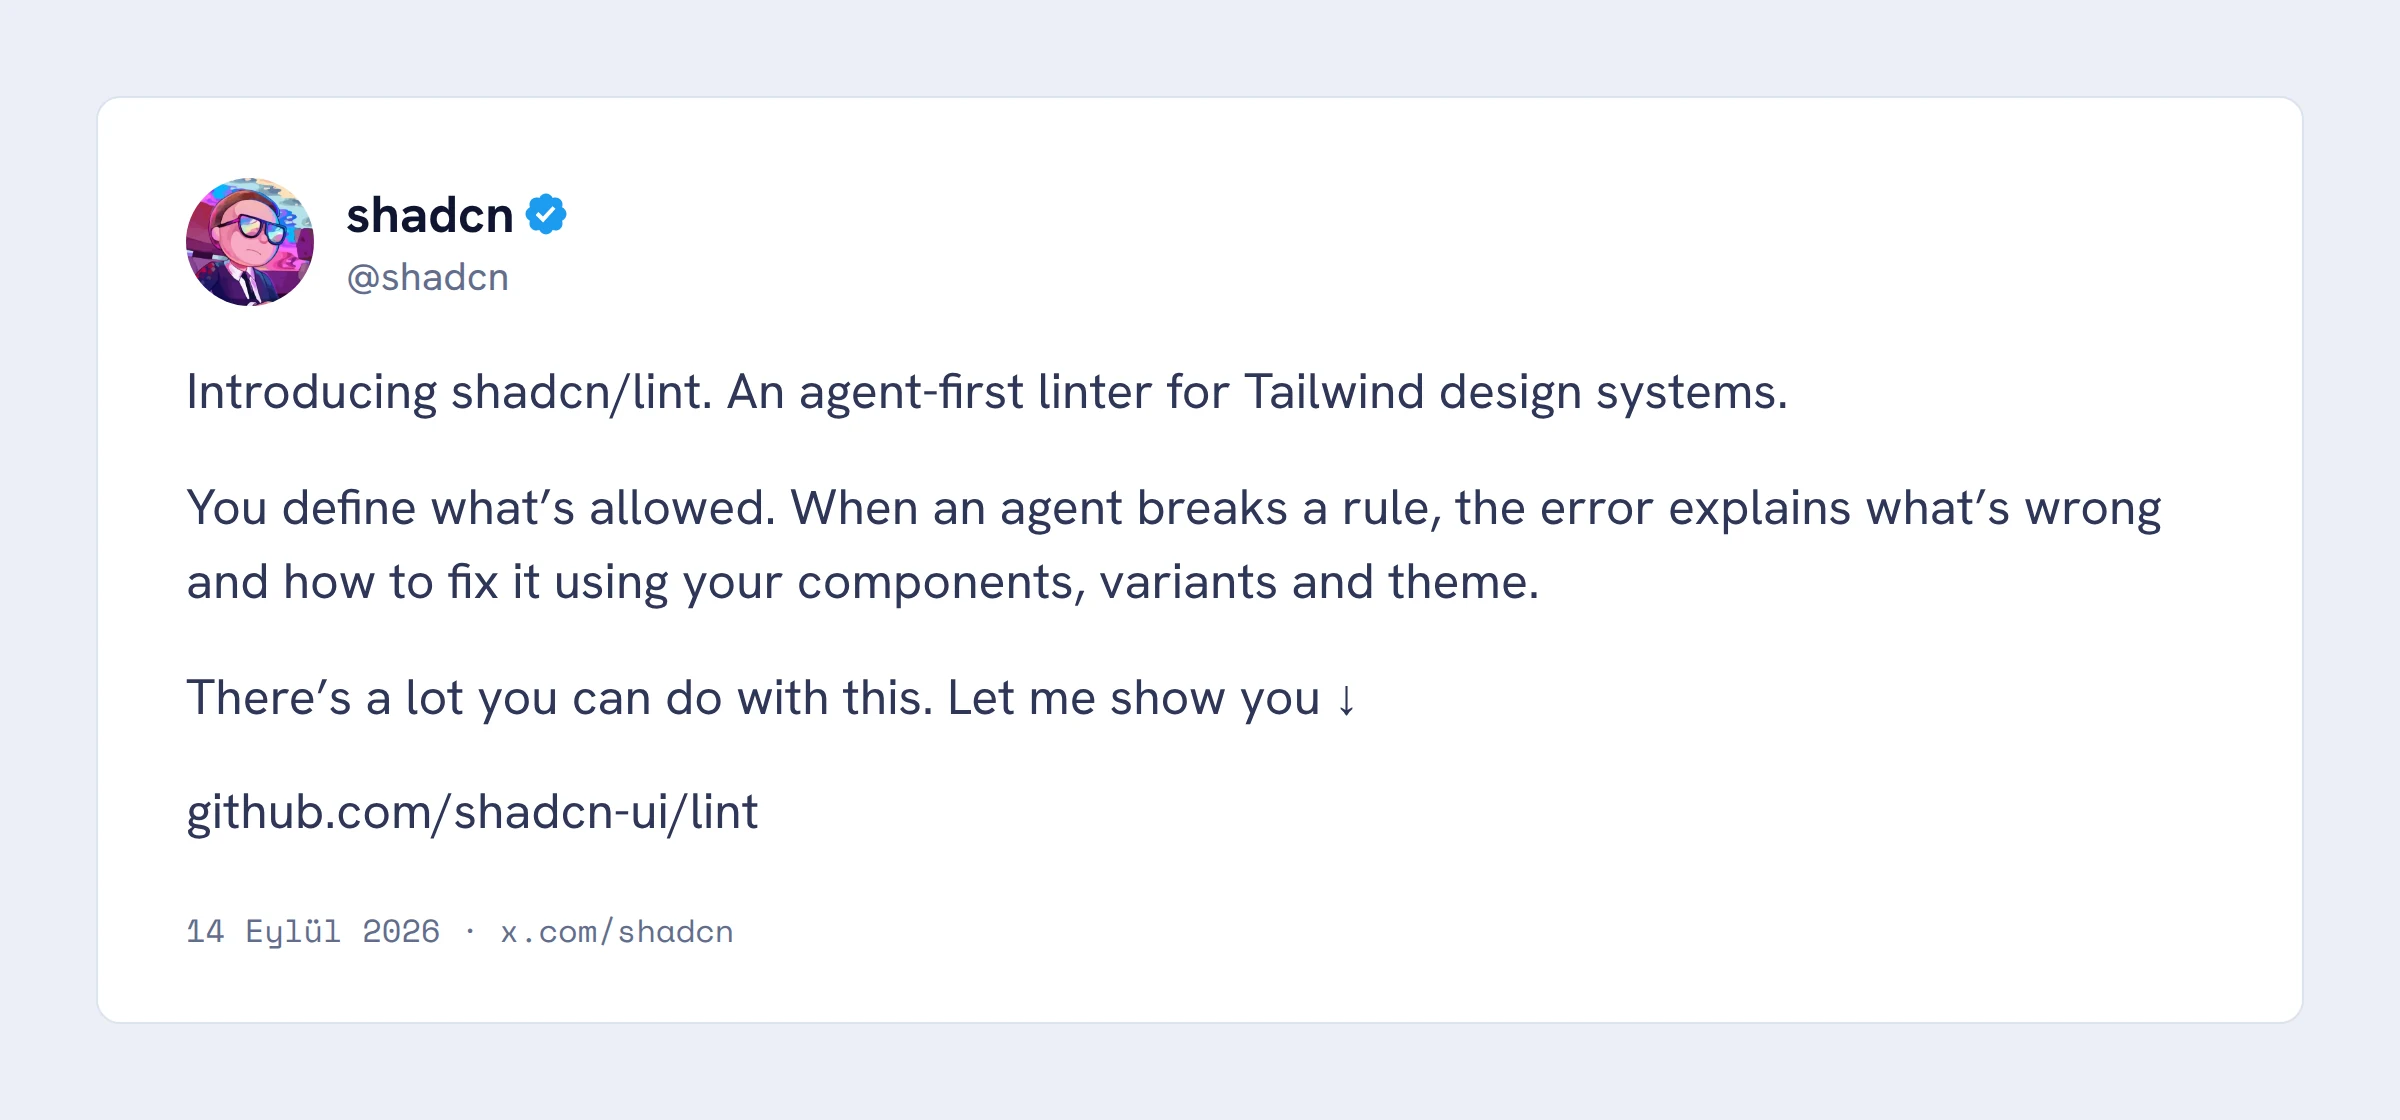
14 Eylül’de çıkan linter altı kuralla geliyor: bileşeni className ile yeniden stillemek, ham renk, keyfi değer, inline stil, bilinmeyen class ve dinamik class. Ajan bir kuralı çiğnediğinde hata mesajı sadece “yasak” demiyor; sistemdeki doğru boyutu ya da varyantı gösteriyor. shadcn’in kendi eval’lerinde linter olmadan Sonnet 5 sekiz görevde 50 ile 80 arası ihlal üretiyor. Hiçbir stil talimatı içermeyen görevlerde bile ajanlar kendilerine verilen bileşenleri çoğu zaman yeniden stilliyor. Linter geri bildirimiyle 150’yi aşan görevin neredeyse tamamı tek turda sıfıra iniyor. Düzeltme de yalnızca yazılı kurallara göre %10 ile %48 arası daha ucuz.
İki hafta önce Christoph Hellmuth’un yayımladığı open-design-system-bench aynı soruyu sistemin tarafından soruyor. Nord Security’nin Aurora sistemiyle başlayan açık benchmark, ajanlara bileşen adı vermeyen görevler veriyor. Çıktıyı import, API sadakati, token disiplini, erişilebilirlik ve derlenme üzerinden puanlıyor. Dört sistemin hiçbiri “AI-native” eşiği olan 70 puana ulaşamamış.
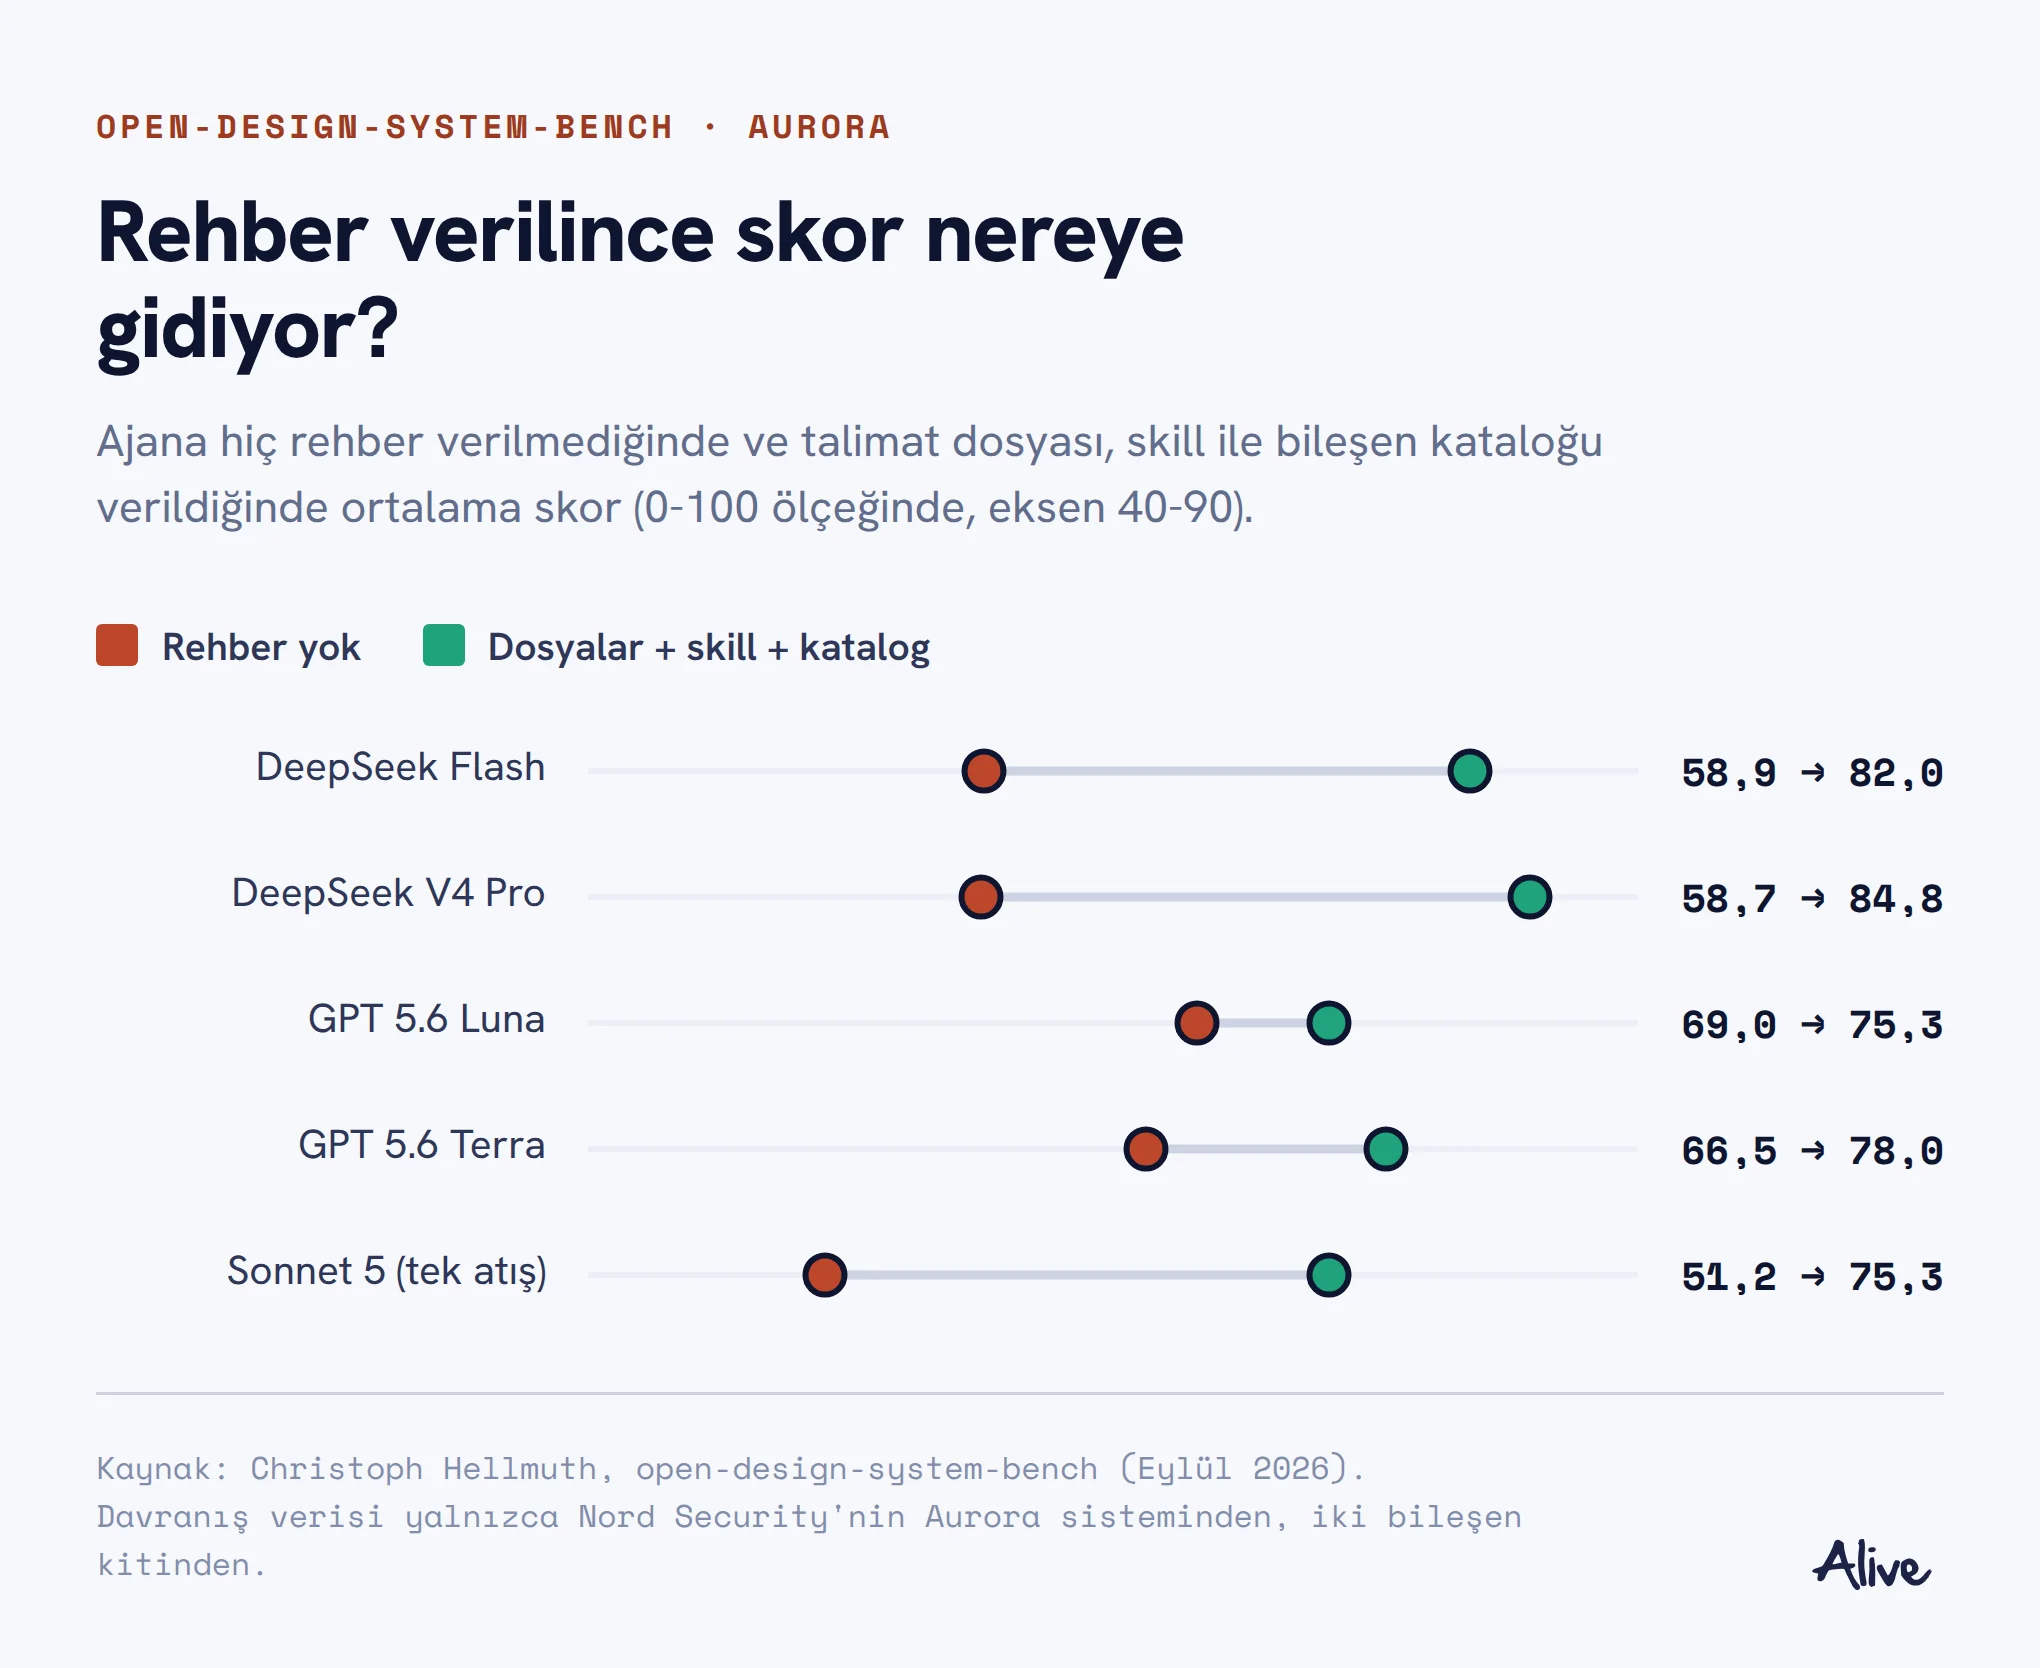
Bench’in en öğretici bulgusu bir tuzak. GPT 5.6 Terra çıktıların %94’ünü derletmiş, ama görevlerin %63’ünde tasarım sistemine hiç dokunmamış. Ortalamaya bakınca kazanan gibi görünüyor; sistem ekibi için ise en kötü sonuç bu. Rehberin etkisi de dikkat çekici. DeepSeek V4 Pro 58,7’den 84,8’e, tek atışlık Sonnet 5 51,2’den 75,3’e çıkıyor. Sıçramanın büyük kısmı hiç doküman olmamasıyla bir talimat dosyası olması arasında.
Küçük üreticiler de aynı yerde. Figma’da sistem kullanımını ve ham değerleri denetleyen Design Review eklentisi ile bileşeni her durumda render edip açıklarını bulan /break skill’i, denetimin kod tarafıyla sınırlı kalmadığını gösteriyor.
İki test, iki farklı soru
Karşı okuma da seçkinin kendi içinden çıkıyor. Harsh Raval’in testi yanlış bir soru sormuyor; sadece farklı bir durumu ölçüyor.
Boş tuval testi
- Sistemi olmayan, sıfırdan başlayan ekip için doğru soru.
- İlk çıktıyı ve düzeltme kolaylığını ölçüyor.
- Ama gördüğün şey modelin ortalaması: Start free ve mavi buton.
Sistem testi
- Mevcut bir ürüne ekleme yapan ekip için doğru soru.
- Ham rengi, keyfi değeri, elle yazılmış bileşeni sayıyor.
- Aracın yanında sistemin okunabilirliğini de ölçüyor.
Bu bir seçki, örneklem değil. Örneklerin çoğu yapımcılarının kendi anlattığı denemeler; kalıp gerçek ama işe yaradığına dair bağımsız kanıt henüz yok. shadcn/lint’in eval’lerini shadcn kendisi yaptı ve Vercel’in bu yönde açık bir çıkarı var. Bench’in ajan davranışı verisi şimdilik yalnızca Aurora’dan geliyor. DHM’deki %90 yazarın kendi değerlendirmesi. Girişteki sayımımız da dört sayfa ve tek bir prompt’tan ibaret.
Soru araçtan sisteme kaydı
İki taraf da yarı haklı. Boş tuval testi sistemi olmayan için gerçekten işe yarıyor, sistem sadakati ise ürünü olan herkesin asıl derdi. Ama üç haftalık seçkiden çıkan şey başka: bu örneklerin neredeyse hiçbiri bir araç seçmiyor. Hepsi sistemi, hangi araç gelirse gelsin okunabilir ve denetlenebilir hale getiriyor. Bench’teki en büyük sıçramanın modeller arasında değil, doküman olup olmaması arasında çıkması da tesadüf değil.
Şimdilik bulduğumuz çıkış noktası şu: araç seçmeden önce sistemin bozulduğunu fark edebildiğin bir ölçü kur. O ölçü olmadan her kıyaslama izlenim olarak kalıyor (bu yazının girişindeki sayım dahil).
Araçlar her ay değişiyor. Sistemin bozulduğunu gösteren ölçü sende kalmalı.
Ürünündeki mevcut bir ekranı, bileşen adı vermeyen aynı prompt’la iki araca yeniden yaptır. Üç şeyi say: ham renk değerleri, sistemde olmayan boşluk değerleri ve sistem bileşeni yerine elle yazılmış bileşenler. Tailwind kullanıyorsan shadcn/lint’in no-raw-colors ve no-arbitrary-values kuralları bu sayımı senin yerine yapar.
Senin ekibinde son AI aracı seçimi hangi demoyla yapıldı: boş bir tuvalde mi, kendi sisteminin içinde mi? Bizce önümüzdeki dönemin tasarım sistemi ekibi, en güzel ekranı üreten aracı değil, sistemin ne zaman bozulduğunu en erken gösteren ölçüyü seçen ekip olacak.
Sevgiyle kalın! 🧱